
Indice dei contenuti dell'articolo:
Chi gestisce l’hosting di un e-commerce conosce bene questa scena. Il server è carico, i processi PHP sono tutti occupati, il database macina query su query, eppure Google Analytics dice che sul sito ci sono quaranta persone. Si aprono i log e la risposta è sempre la stessa: migliaia di richieste al minuto su URL come /scarpe/?colore=nero&taglia=42&prezzo=50-100&ordina=prezzo&p=7. Non è un attacco nel senso classico del termine. È un crawler che sta esplorando, combinazione dopo combinazione, la navigazione faccettata del catalogo.
La navigazione faccettata è uno strumento eccellente per le persone e un pozzo senza fondo per i bot. Fino a qualche anno fa il problema riguardava soprattutto Googlebot e qualche crawler SEO. Oggi è esploso, perché sulla scena sono arrivati i crawler delle aziende di intelligenza artificiale, molti dei quali non rispettano le regole che il web si è dato in trent’anni e alcuni dei quali si travestono da normali browser per non farsi riconoscere.
In questo articolo provo a spiegare il problema dal punto di vista di chi gestisce i server, perché non conviene lasciare i filtri aperti nemmeno ai bot “buoni”, cosa consiglia Google e perché la promessa di “servire i bot dalla cache”, che qualcuno vende come soluzione, non regge alla prova dei numeri.
Che cos’è la navigazione faccettata e perché genera URL infinite
La navigazione faccettata è il sistema di filtri che trovi a sinistra o in alto in quasi ogni catalogo: marca, colore, taglia, fascia di prezzo, materiale, disponibilità, prodotti in offerta. Ogni volta che l’utente seleziona un filtro, la piattaforma genera una nuova URL con un nuovo parametro. WooCommerce, Magento e PrestaShop lo fanno tutti, ciascuno con la propria sintassi.
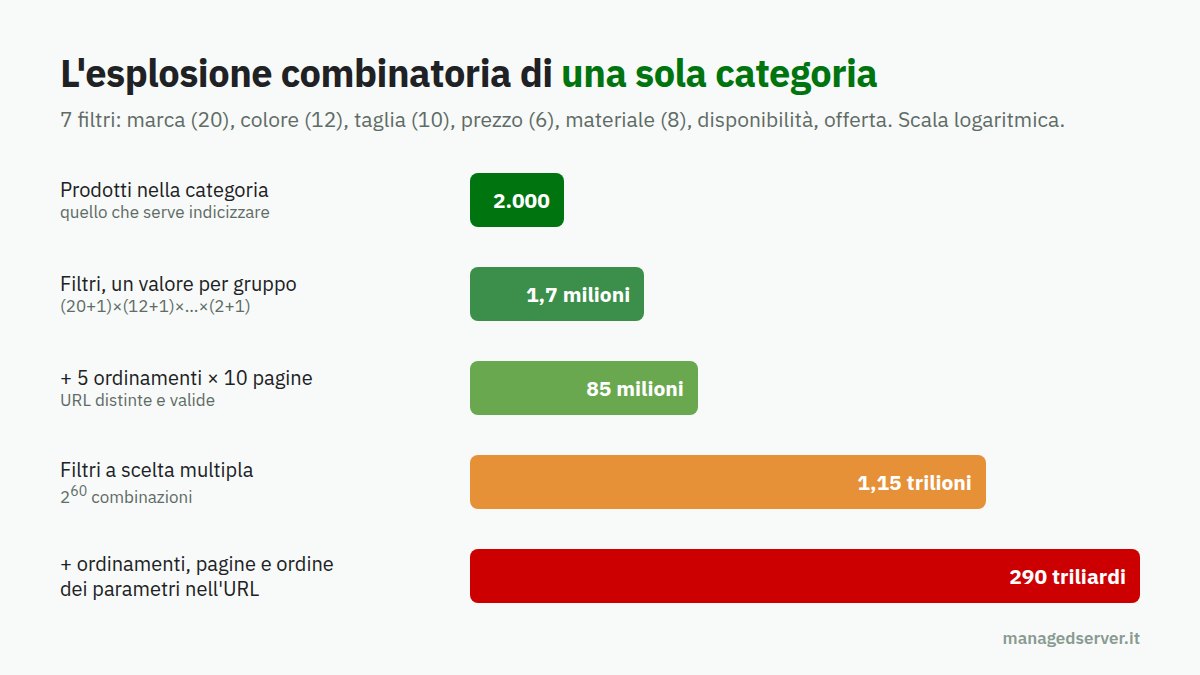
Il punto è che ogni combinazione di filtri è una URL diversa, e le combinazioni crescono in modo moltiplicativo, non additivo. Prendiamo una sola categoria di un negozio di calzature con sette gruppi di filtri: 20 marche, 12 colori, 10 taglie, 6 fasce di prezzo, 8 materiali, disponibilità sì o no, in offerta sì o no. In tutto sono 60 valori.
- Se l’utente può scegliere un solo valore per gruppo, le combinazioni sono (20+1)×(12+1)×(10+1)×(6+1)×(8+1)×(2+1)×(2+1) = 1.702.701.
- Aggiungiamo 5 ordinamenti e 10 pagine di risultati: si arriva a 85 milioni di URL distinte e perfettamente valide.
- Se i filtri sono a scelta multipla, come accade quasi sempre per colori e taglie, ogni valore può essere acceso o spento: 260 = 1.152.921.504.606.846.976 combinazioni, cioè circa 1,15 trilioni.
- Se poi la piattaforma non normalizza l’ordine dei parametri,
?colore=nero&taglia=42e?taglia=42&colore=nerosono due URL diverse. Con ordinamenti, pagine e le permutazioni dei sette parametri si superano i 290 triliardi.
Il tutto per una categoria che contiene, magari, duemila prodotti. I contenuti utili sono duemila; le URL raggiungibili sono un numero che non ha più senso fisico.
Il problema visto dal server
Una pagina di categoria filtrata è una delle pagine più costose che un e-commerce possa generare. Non basta leggere un prodotto: bisogna applicare i filtri, contare i risultati per ogni valore di ogni filtro (i famosi numerini tra parentesi), ordinare, paginare, calcolare prezzi e disponibilità. Su Magento si attraversano le tabelle degli attributi e degli indici, su WooCommerce le tassonomie e i meta, su PrestaShop i moduli di navigazione a strati. Su cataloghi grandi una singola pagina filtrata può richiedere da qualche centinaio di millisecondi a diversi secondi di CPU e decine di query al database.
Facciamo un conto prudente: 0,3 secondi di CPU per pagina. Un crawler che visita un milione di combinazioni al giorno, numero tutt’altro che raro sui cataloghi che gestiamo, consuma 83 ore di CPU al giorno solo per generare pagine che nessun essere umano vedrà mai. Tradotto: processi PHP-FPM saturi, code di richieste, database sotto pressione, tempi di risposta che salgono per i clienti veri, carrelli che si bloccano e, nel peggiore dei casi, il sito che va giù durante una campagna pubblicitaria.
Non è un’ipotesi accademica. Lo stesso Google, in una revisione dei problemi di scansione segnalati nel 2025 discussa da Gary Illyes nel podcast Search Off the Record e riportata da Search Engine Land, ha attribuito circa la metà dei problemi alla navigazione faccettata e un altro quarto ai parametri di azione come ordinamento e carrello. Tre problemi di scansione su quattro nascono da URL generate da filtri e parametri.
I nuovi crawler AI: niente crawl-delay, poco robots.txt, molti travestimenti
Per anni il patto tra siti e crawler si è retto su due strumenti: il file robots.txt, che dice cosa si può scansionare, e la direttiva Crawl-delay, che chiede di rallentare. Entrambi sono richieste di cortesia. Nessuno obbliga un crawler a rispettarle.
Il primo dettaglio che molti ignorano è che Google la direttiva crawl-delay non la supporta affatto: la sua documentazione sul robots.txt lo dice esplicitamente. Bing e pochi altri la considerano, ma per una larga parte dei crawler moderni è una riga di testo senza effetto.
Il secondo dettaglio è più grave. Con la corsa ai dati per addestrare e alimentare i modelli di intelligenza artificiale, sono comparsi crawler che il robots.txt lo ignorano o lo interpretano a modo loro. Ne avevamo già parlato in questo articolo sulle AI che non rispettano il robots.txt e in quello su come metà del traffico web non sia più umano.
Il caso più documentato è quello che Cloudflare ha pubblicato ad agosto 2025 su Perplexity. Secondo il rapporto di Cloudflare, quando il crawler dichiarato veniva bloccato entrava in azione un crawler non dichiarato, con uno user agent generico che imitava Google Chrome su macOS, da indirizzi IP fuori dagli intervalli pubblicati e con rotazione di IP e reti per aggirare i blocchi. Cloudflare riferisce anche che il robots.txt veniva ignorato o non veniva nemmeno scaricato. Perplexity ha contestato quelle conclusioni, ma il comportamento descritto è esattamente quello che osserviamo ogni giorno nei log dei nostri clienti, da molte fonti diverse.
Dal punto di vista del server questo cambia tutto. Un bot che si presenta come Chrome, ruota indirizzi IP residenziali e ignora robots.txt non si distingue da un cliente guardando solo lo user agent. E un bot che non conosce il catalogo, non ha fretta e non ha un budget di scansione segue ogni link di filtro che trova, generando proprio quelle combinazioni che nessun utente reale genererebbe mai.
Perché non conviene lasciare i filtri aperti nemmeno a Google, Claude, Meta e OpenAI
La reazione istintiva è distinguere tra bot buoni e bot cattivi: blocchiamo quelli che si nascondono e lasciamo passare Googlebot, Bingbot, ClaudeBot, Meta-ExternalAgent, GPTBot e gli altri crawler dichiarati. Sui prodotti e sulle categorie è giusto. Sui filtri è uno spreco anche per loro.
Pensiamo a cosa serve a un motore di ricerca o a un assistente AI per conoscere un catalogo. Serve la scheda di ciascun prodotto, con nome, descrizione, prezzo, disponibilità e dati strutturati. Servono le pagine di categoria, che organizzano i prodotti e li collegano. Tutto qui. La pagina “scarpe nere, taglia 42, in pelle, tra 50 e 100 euro, ordinate per prezzo, pagina 7” non contiene nessuna informazione che non sia già presente nelle schede dei singoli prodotti. È un sottoinsieme, una vista temporanea, quasi sempre un contenuto duplicato o povero.
Per questo il catalogo filtrato non va indicizzato: è l’insieme delle schede prodotto che va indicizzato. E le schede prodotto, a differenza delle combinazioni di filtri, sono un insieme finito, stabile e ripetuto, che una normale web cache come Varnish gestisce benissimo. Il bot che legge la scheda del prodotto la riceve in pochi millisecondi dalla cache; il bot che esplora i filtri obbliga il server a calcolare ogni volta una pagina nuova, per un risultato che non porta né posizionamento né visibilità nelle risposte delle AI.
Lasciare aperti i filtri a Googlebot, poi, ha un costo SEO concreto: il tempo che Google passa a scansionare combinazioni inutili è tempo che non passa sui prodotti nuovi o aggiornati. Google stesso lo scrive, come vediamo subito.
Cosa consiglia Google sulla navigazione faccettata
Google ha una pagina dedicata, Managing crawling of faceted navigation URLs, ed è sorprendentemente netta. Spiega che i crawler, prima di capire che quelle URL sono inutili, ne visitano un numero molto grande, che la scansione delle URL faccettate tende a costare ai siti grandi quantità di risorse di calcolo e che il tempo speso su URL inutili viene tolto alle URL nuove e utili.
Le raccomandazioni si dividono in due casi.
Se non ti serve che le pagine filtrate siano indicizzate, cioè nella quasi totalità degli e-commerce:
- blocca i parametri dei filtri con robots.txt, lasciando scansionabile la pagina di elenco senza filtri. Google scrive che spesso non c’è alcun buon motivo per consentire la scansione degli elementi filtrati;
- in alternativa usa i frammenti di URL (la parte dopo il carattere
#) per i filtri, perché i frammenti non hanno alcun effetto sulla scansione; rel="canonical"erel="nofollow"aiutano, ma Google li definisce in genere meno efficaci nel lungo periodo; per il nofollow, inoltre, ogni singolo link verso quella URL deve averlo.
Se invece ti serve che alcune pagine filtrate siano scansionate e indicizzate:
- usa il separatore standard
&tra i parametri; - mantieni sempre lo stesso ordine dei filtri ed evita filtri duplicati nella stessa URL;
- restituisci un 404 quando una combinazione non produce risultati, quando è duplicata o priva di senso, o quando la paginazione va oltre l’ultima pagina, senza reindirizzare a una pagina generica.
Notate una cosa: il noindex non compare tra gli strumenti per ridurre la scansione. Una pagina in noindex deve comunque essere scaricata per leggere il noindex. Dal punto di vista del server, il costo di generarla resta tutto.
La falsa promessa: “serviamo i bot dalla cache”
Qualche giorno fa abbiamo analizzato l’annuncio di un hosting che propone di servire i crawler AI dalla cache invece di bloccarli. Non è l’unico: l’idea circola, ed è commercialmente attraente perché promette di non dover scegliere. Il bot passa, il negozio non soffre, tutti contenti.
Il problema è che una cache funziona solo se la stessa risorsa viene richiesta più volte. È la sua definizione: la prima richiesta paga il costo di generazione (MISS), le successive vengono servite dalla copia (HIT). Funziona splendidamente su un insieme finito di pagine richieste da molti utenti, come la home, le categorie e le schede prodotto. Non può funzionare su un insieme di URL che conta trilioni di elementi, in cui un crawler visita ogni combinazione una volta sola.
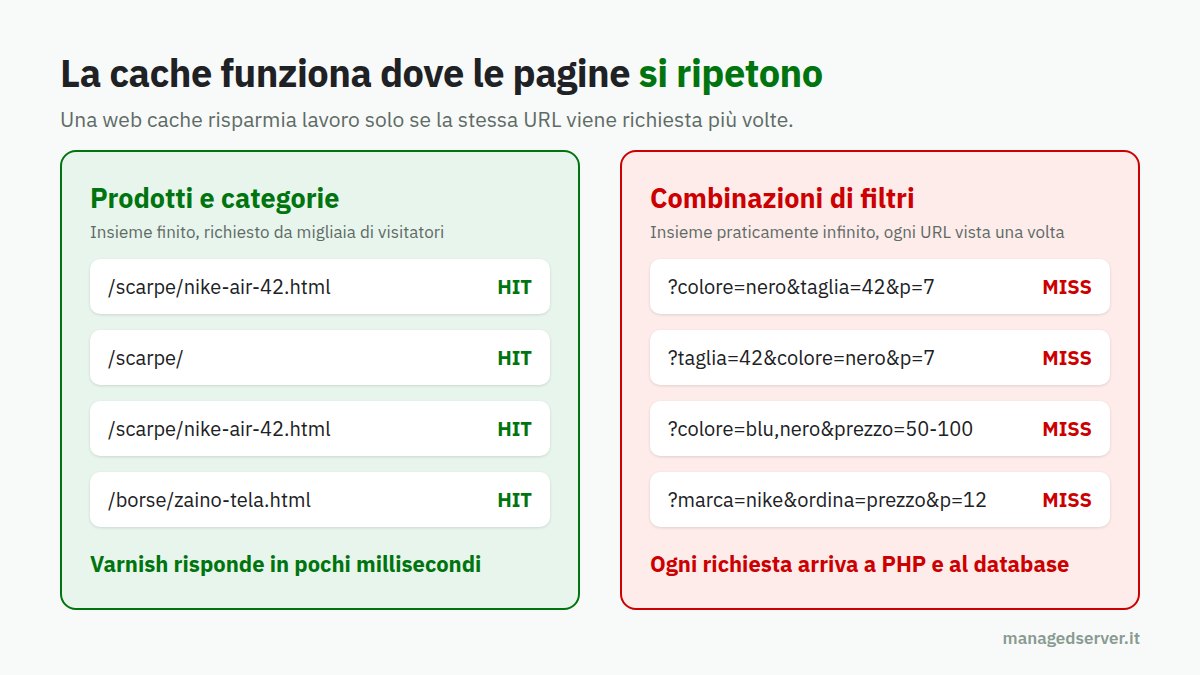
Rifacciamo i conti con l’esempio di prima. Per mettere in cache in anticipo le 1,15 trilioni di combinazioni di una sola categoria, anche a 50 KB per pagina, servirebbero circa 57 zettabyte di spazio, cioè 57 miliardi di terabyte. Per generarle, a 0,3 secondi l’una, servirebbero circa 11 miliardi di anni di CPU. E se non le generi in anticipo, ogni prima visita del bot è un MISS: proprio il caso costoso che la cache doveva evitare.
C’è poi un dettaglio che rende la promessa ancora più fragile. I prezzi cambiano, le disponibilità cambiano, i prodotti entrano ed escono dal catalogo. Una cache di pagine filtrate andrebbe invalidata continuamente, e ogni invalidazione riporta tutto allo stato di partenza. La cache non riduce il numero di combinazioni: sposta solo il problema dalla CPU alla memoria, e nemmeno quella basta.
Chi vende “cache per i bot” sui filtri senza dichiarare quante URL vengono effettivamente servite dalla cache, con quale hit ratio e su quale catalogo, sta vendendo un’etichetta. Il conto di quella promessa lo paga il negozio, quando i bot continuano a generare MISS e i clienti veri trovano il sito lento.
Cosa fare davvero: la strategia di un hosting che conosce i cataloghi
La soluzione non è una singola regola ma una serie di livelli, ciascuno dei quali ferma una categoria diversa di bot. Nessuno basta da solo, e l’ordine conta.
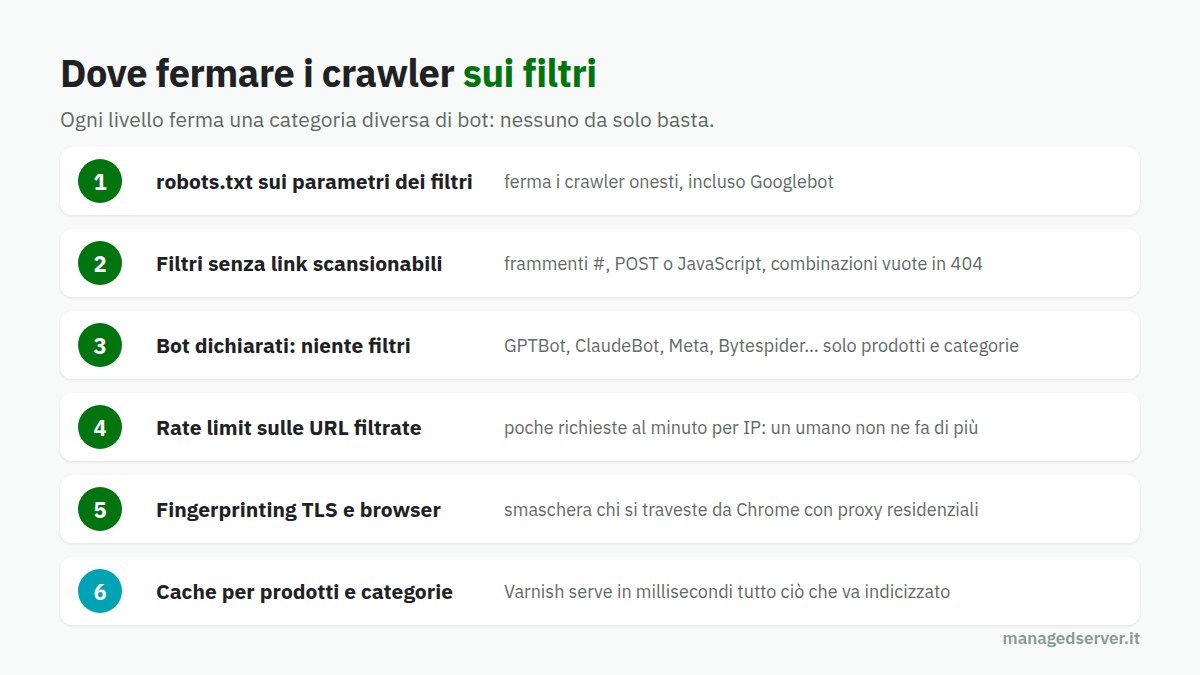
1. Chiudere i filtri ai crawler con robots.txt
È il primo passo e ferma tutti i crawler onesti, Googlebot compreso. Un esempio per WooCommerce, da adattare ai parametri reali del proprio negozio:
User-agent: *
Disallow: /*?*filter_
Disallow: /*?*query_type_
Disallow: /*?*min_price=
Disallow: /*?*max_price=
Disallow: /*?*rating_filter=
Disallow: /*?*orderby=
Disallow: /*?*add-to-cart=
Su Magento i parametri della navigazione a strati dipendono dagli attributi del catalogo (per esempio color, size, price, manufacturer) più product_list_order, product_list_dir e product_list_limit. Su PrestaShop i filtri del modulo di ricerca a faccette passano di solito dal parametro q. Prima di pubblicare un robots.txt va sempre verificato che non blocchi le schede prodotto, le categorie senza filtri e le risorse CSS e JavaScript.
2. Non offrire link scansionabili verso le combinazioni
Se i filtri sono link normali, qualsiasi crawler li segue. Se invece le combinazioni sono gestite con frammenti #, con richieste POST o con JavaScript che aggiorna la pagina, per un crawler semplicemente non esistono. Insieme a questo, conviene normalizzare l’ordine dei parametri, limitare il numero di filtri combinabili e restituire 404 per le combinazioni vuote, come chiede Google.
3. I bot dichiarati leggono prodotti e categorie, non i filtri
GPTBot, ClaudeBot, Meta-ExternalAgent, PerplexityBot, Bytespider, Amazonbot, CCBot e gli altri crawler che si dichiarano possono e devono poter leggere le schede prodotto, che arrivano dalla cache. Sulle URL filtrate, invece, la risposta corretta è un 403. Per Googlebot e Bingbot vale lo stesso principio, con un’accortezza: va verificato che siano davvero loro tramite reverse DNS, perché lo user agent di Googlebot è il primo che i bot falsi copiano.
4. Limitare la frequenza delle richieste sulle URL filtrate
Un essere umano non apre trenta combinazioni di filtri al minuto. Un limite di frequenza applicato solo alle URL con parametri di filtro non disturba i clienti e taglia le gambe a chi esplora il catalogo a tappeto. Su NGINX, per esempio:
map $args $ms_filtri {
    default 0;
    "~(^|&)(filter_|query_type_|min_price|max_price|rating_filter|orderby)" 1;
}
map $http_user_agent $ms_bot_dichiarato {
    default 0;
    "~*(gptbot|claudebot|meta-externalagent|perplexitybot|bytespider|amazonbot|ccbot)" 1;
}
map "$ms_filtri:$ms_bot_dichiarato" $ms_blocca {
    default 0;
    "1:1"   1;
}
# chiave vuota = richiesta non conteggiata: il limite vale solo per le URL filtrate
map $ms_filtri $ms_chiave_filtri {
    0 "";
    1 $binary_remote_addr;
}
limit_req_zone $ms_chiave_filtri zone=filtri:10m rate=20r/m;

server {
    # ...
    if ($ms_blocca) { return 403; }
    limit_req zone=filtri burst=10 nodelay;
    limit_req_status 429;
}
È un esempio didattico: in produzione le regole vanno costruite sui parametri reali del negozio e verificate sui log.
5. Smascherare chi si traveste
I livelli precedenti non fermano chi si presenta come Chrome da un indirizzo residenziale e cambia IP a ogni richiesta. Qui servono strumenti che guardano oltre lo user agent: il fingerprinting TLS, che riconosce le librerie usate dai bot anche quando dichiarano di essere un browser, e il fingerprinting del browser, eventualmente con una verifica JavaScript leggera solo sulle combinazioni profonde di filtri. Ne abbiamo parlato anche in come costruire sistemi anti-bot efficaci.
6. La cache dove serve davvero
Chiusi i filtri, la cache torna a fare il suo mestiere: servire in pochi millisecondi home, categorie e schede prodotto a clienti e bot. È lì che una web cache come Varnish dà il meglio, con hit ratio altissimi, perché l’insieme delle pagine è finito e molto richiesto.
Conclusioni
La navigazione faccettata è nata per le persone e deve restare alle persone. Ai motori di ricerca e agli assistenti AI servono le schede prodotto e le categorie, non le combinazioni dei filtri, e le schede prodotto si servono benissimo da una cache classica. Le combinazioni, invece, sono un insieme che cresce fino a numeri che non hanno più senso fisico: nessuna cache può contenerle e nessun server dovrebbe generarle per un bot.
Bloccare i bot sui filtri non è una scelta difensiva o pigra: è l’unica scelta coerente con i numeri, ed è esattamente quella che suggerisce Google. Tutto il resto, comprese le promesse di “servire i bot dalla cache”, è marketing che sposta il costo sul cliente.
Se il tuo e-commerce soffre di carichi anomali, rallentamenti senza spiegazione o picchi di traffico che non si trasformano in vendite, è molto probabile che qualcuno stia esplorando i tuoi filtri. Su piattaforme come WooCommerce, Magento e PrestaShop analizziamo i log, individuiamo i crawler e costruiamo le regole su misura del catalogo, senza togliere visibilità ai prodotti.

