
Indice dei contenuti dell'articolo:
Per oltre un decennio il mercato dell’hosting ha funzionato secondo una formula piuttosto semplice e, per molto tempo, assolutamente efficace: vendere piani hosting mettendo a disposizione un certo numero di gigabyte di spazio, un interprete PHP, un database MySQL o MariaDB e un web server Apache.
Con il passare degli anni l’offerta si è evoluta. Apache è stato affiancato o sostituito da tecnologie considerate più performanti, come LiteSpeed o NGINX, mentre nei servizi più evoluti sono comparsi Varnish, Redis, object cache, storage NVMe, HTTP/2, HTTP/3 e configurazioni sempre più raffinate di PHP-FPM.
In sostanza, il concetto di Hosting WordPress ottimizzato è stato costruito per anni quasi esclusivamente intorno allo stack tecnologico lato server.
E per molto tempo ha funzionato.
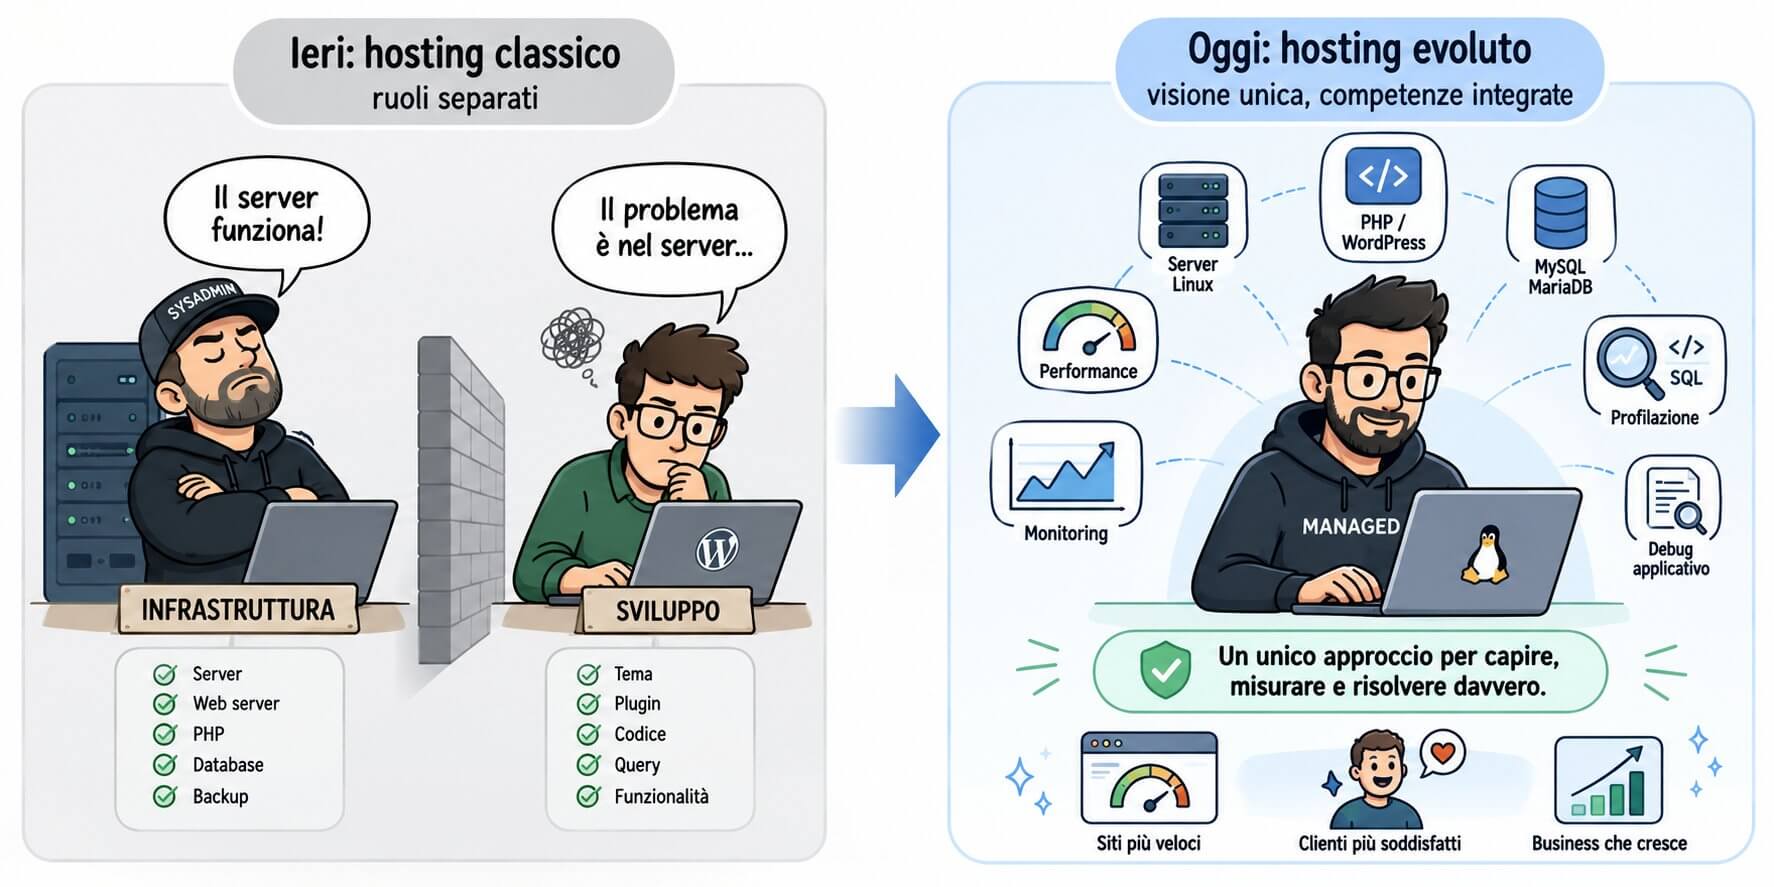
Ha funzionato perché il contesto era profondamente diverso da quello attuale e perché esisteva una separazione dei ruoli molto più netta: l’hosting faceva l’hosting, il sistemista faceva il sistemista e lo sviluppatore faceva lo sviluppatore.
Per oltre dieci anni la separazione dei ruoli ha funzionato
L’Hosting Provider si occupava dell’infrastruttura: server, rete, sistema operativo, PHP, database, backup, spazio disco, disponibilità del servizio e, nei casi migliori, sicurezza e monitoraggio.
Lo sviluppatore si occupava invece del sito vero e proprio: sceglieva il tema, installava e configurava i plugin, sviluppava eventuali personalizzazioni e gestiva l’impostazione generale del progetto.
Il cliente finale, molto spesso, non conosceva nemmeno il nome dell’Hosting Provider sul quale era ospitato il proprio sito.
In numerosi casi l’hosting veniva acquistato direttamente dallo sviluppatore o dall’agenzia, che lo fatturava poi al cliente finale applicando le proprie maggiorazioni. Per il cliente esisteva semplicemente il professionista che gli aveva realizzato il sito e che continuava ad esserne il referente.
Anche il Web, dal punto di vista del traffico automatico, era molto diverso.
C’erano certamente i crawler dei motori di ricerca: Google, Bing, Yahoo, Yandex e pochi altri. Ma non esisteva la quantità di bot, scraper, scanner, servizi automatici, comparatori, crawler SEO e soprattutto AI Bot che oggi visitano continuamente qualunque sito pubblicamente raggiungibile.
Parole come AI Bot, crawler per modelli linguistici o scraping automatizzato su larga scala non esistevano nemmeno nell’anticamera del cervello della maggior parte di sviluppatori e sistemisti.
Tutto funzionava quindi in maniera più lineare e a compartimenti relativamente stagni.
Se il sito era lento, lo sviluppatore passava la palla al sistemista.
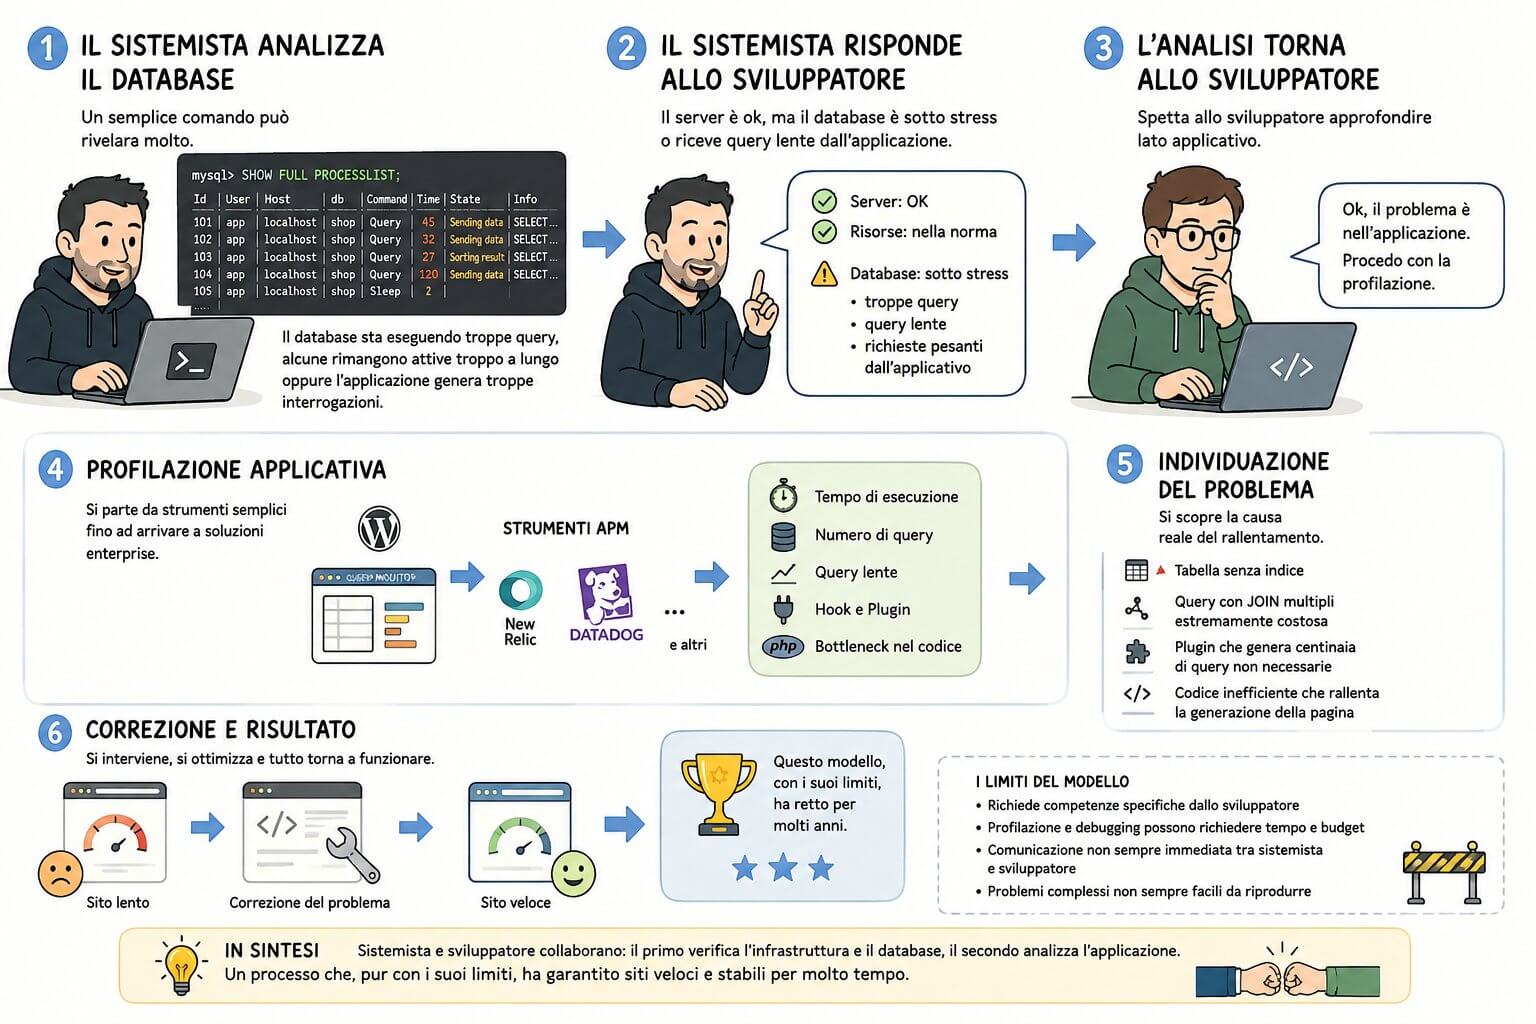
Il sistemista controllava CPU, memoria, I/O disco, processi PHP, connessioni al database e stato generale del server. Se non emergevano problemi infrastrutturali, uno dei controlli classici consisteva nell’osservare cosa stesse succedendo su MySQL o MariaDB.
Anche un semplice:
SHOW FULL PROCESSLIST;
poteva essere sufficiente per capire che il database stava eseguendo troppe query, che alcune query rimanevano attive troppo a lungo oppure che l’applicazione stava generando un numero anomalo di interrogazioni.
A quel punto il sistemista poteva rispondere allo sviluppatore dicendo, sostanzialmente: il server non presenta problemi particolari, ma il database sta lavorando troppo oppure ci sono query lente che arrivano dall’applicativo.
La responsabilità dell’analisi tornava quindi allo sviluppatore che, budget permettendo, decideva eventualmente di sporcarsi le mani con una vera profilazione applicativa.
Nel mondo WordPress si poteva partire dal semplice Query Monitor. Nei progetti più strutturati si potevano utilizzare strumenti più evoluti come New Relic, Datadog o altre piattaforme APM.
Si individuava la tabella senza indice, la query con JOIN multiple estremamente costosa, il plugin che effettuava centinaia di query non necessarie oppure una determinata porzione di codice che rallentava l’intera generazione della pagina.
Si correggeva il problema e tutto tornava a funzionare.
Questo modello, con tutti i suoi limiti, ha retto per molti anni.
Negli ultimi anni questa formula ha smesso di funzionare
Nel corso degli ultimi anni la situazione è cambiata profondamente.
Oggi, quando un sito è lento, per il cliente la responsabilità è quasi sempre dell’Hosting.
Dal suo punto di vista è anche un’associazione piuttosto naturale: il sito è lento, il sito si trova su un server, il server è fornito dall’Hosting Provider, quindi il problema deve essere l’hosting.
Il cliente non tecnico non è tenuto a conoscere la differenza tra una CPU satura, una query senza indice, un loop PHP, una richiesta HTTP esterna che impiega cinque secondi, un hook eseguito centinaia di volte o un database configurato male.
Vede una pagina che impiega troppo tempo a caricarsi e cerca una spiegazione semplice.
Le ultime due migrazioni di questo tipo che abbiamo gestito riguardavano due e-commerce: un PrestaShop e un WooCommerce.
Entrambi erano considerati lenti. In entrambi i casi i rispettivi clienti erano convinti che la responsabilità fosse dell’Hosting Provider. E in entrambi i casi, almeno inizialmente, anche gli sviluppatori avevano sostanzialmente seguito la stessa interpretazione, senza mettere davvero in discussione che il problema potesse trovarsi nell’applicativo o nel database.
Il primo caso riguardava un e-commerce PrestaShop sul quale era installato PayPlug.
Lo sviluppatore aveva lasciato attiva una funzionalità legata al pagamento Oney che, di fatto, sul sito non veniva utilizzato.
Il comportamento individuato durante la profilazione era molto preciso.
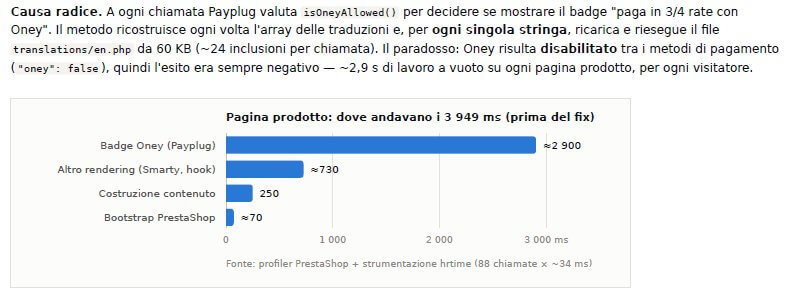
Ad ogni chiamata PayPlug eseguiva isOneyAllowed() per decidere se mostrare il badge relativo al pagamento in tre o quattro rate con Oney.
Il problema era che questo metodo ricostruiva ogni volta l’array delle traduzioni per ogni singola stringa, ricaricando e rieseguendo ripetutamente il file translations/en.php, un file da circa 60 KB.
Parliamo di circa 24 inclusioni per singola chiamata.
Il paradosso era che Oney risultava disabilitato tra i metodi di pagamento.
Quindi tutto quel lavoro veniva eseguito per arrivare, ogni volta, alla conclusione che il badge non dovesse essere mostrato.
La profilazione rendeva il problema ancora più evidente.
Su una pagina prodotto che richiedeva complessivamente circa 3.949 millisecondi per essere elaborata, quasi 2.900 millisecondi erano riconducibili al solo badge Oney di PayPlug.
Il resto del rendering, tra Smarty e hook, utilizzava circa 730 millisecondi. La costruzione del contenuto circa 250 millisecondi. Il bootstrap di PrestaShop circa 70 millisecondi.
In altre parole, circa 2,9 secondi di elaborazione venivano sprecati su ogni pagina prodotto, per ogni visitatore, per stabilire che un metodo di pagamento disabilitato non dovesse essere visualizzato.
Non era un problema di Apache.
Non era un problema di NGINX.
Non era un problema di MariaDB, della velocità degli NVMe o della quantità di RAM disponibile.
Era un problema applicativo che poteva essere individuato soltanto facendo profiling.
Il secondo caso riguardava invece un WooCommerce.
Il sintomo era un load average stabilmente compreso tra 7,7 e 7,9 su una macchina con 8 core, nonostante il traffico fosse sostanzialmente trascurabile.
Non c’erano picchi seguiti da fasi di normalità. Il carico rimaneva alto in maniera prolungata, con un andamento praticamente a plateau.
L’analisi ha permesso di individuare la causa in un loop infinito presente nel tema Woodmart 8.1.2, precisamente nella logica utilizzata per la navigazione tra il prodotto precedente e quello successivo.
A innescare il problema era una situazione molto particolare: due prodotti consecutivi risultavano pubblicati ma contemporaneamente esclusi dalla visibilità del catalogo.
In quella condizione il codice continuava a cercare un prodotto precedente o successivo valido senza raggiungere correttamente una condizione di uscita.
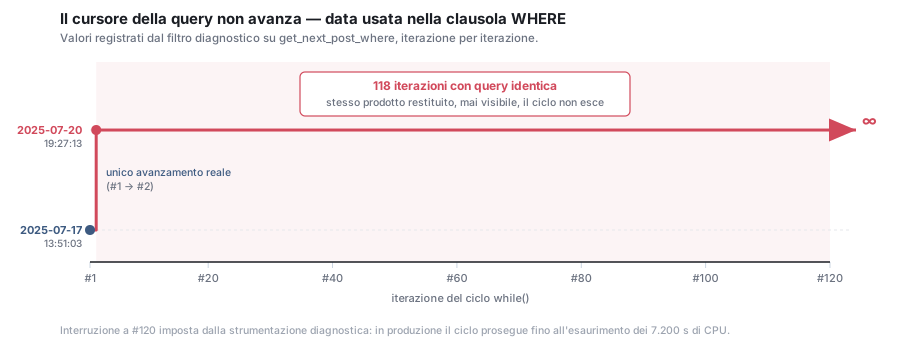
Il costo di una singola richiesta arrivava a 7.200 secondi di CPU.
Tradotto in termini più immediati: una singola richiesta poteva mantenere occupato completamente un core per circa due ore.
E nemmeno la cache riusciva a proteggere il sistema.
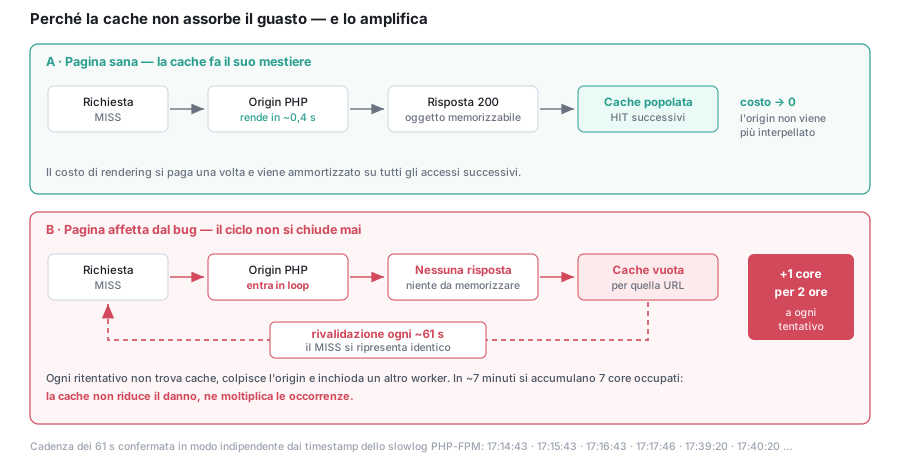
Questo è un aspetto importante, perché spesso si pensa alla cache come a una specie di soluzione universale: se il sito è lento, si mette tutto in cache e il problema scompare.
Ma una cache può memorizzare soltanto una risposta che viene effettivamente prodotta.
In questo caso il MISS entrava nel loop e non arrivava mai a generare una risposta completa e quindi memorizzabile. La richiesta successiva in MISS ripeteva esattamente lo stesso comportamento.
La soluzione è stata un intervento applicativo attraverso un mu-plugin, introducendo un’esclusione SQL dei prodotti non visibili e soprattutto un limite massimo alle iterazioni.
Il risultato dopo l’intervento è stato estremamente chiaro: il load average è passato da 7,70 a 0,28, il TTFB da 1,17 secondi a 0,36 secondi e circa 7 core sono stati restituiti al normale servizio.
Ancora una volta, non si trattava di acquistare una CPU più potente, aumentare la RAM o cambiare tecnologia di web server.
Bisognava trovare il problema.
Ma allora perché sosteniamo che il problema possa essere anche dell’Hosting?
In entrambi questi casi i clienti avevano attribuito la responsabilità delle performance ai rispettivi Hosting Provider.
Anche i loro sviluppatori non avevano inizialmente messo seriamente in discussione questa ipotesi.
Quando sono arrivati da noi chiedendoci a cosa potesse essere dovuta la lentezza, anche noi abbiamo sostenuto che il problema potesse probabilmente essere legato all’hosting.
Qualcuno potrebbe vedere della disonestà in questa affermazione.
In effetti sarebbe stato inopportuno affermare con certezza che la responsabilità fosse del precedente provider prima di aver effettuato un’analisi, una profilazione e delle misurazioni.
E su questo non c’è molto da discutere: prima si misura e poi si conclude.
Ma lasciateci spiegare perché, in fondo, riteniamo comunque di non avere completamente torto.
Come dicevamo all’inizio, fino a oggi l’Hosting Provider ha generalmente fatto l’Hosting Provider.
Pagamento di un canone, creazione automatizzata di un account, consegna di username e password per Plesk o cPanel, disponibilità di PHP, database, spazio web, backup e fine dei giochi.
Ma oggi la domanda è un’altra: chi si preoccupa di capire perché il sito va lento?
Chi controlla, ad esempio, che durante una vecchia migrazione o importazione le tabelle MySQL o MariaDB siano state almeno convertite da MyISAM a InnoDB quando opportuno?
Chi verifica che non ci siano tabelle senza indici adeguati?
Chi si accorge di un loop applicativo?
Chi verifica la presenza di richieste HTTP esterne particolarmente lente?
Chi analizza query SQL inefficienti, plugin che effettuano migliaia di operazioni inutili o comportamenti applicativi anomali?
Se ponete questa domanda a un Hosting Provider tradizionale, soprattutto a un purista della sistemistica, la risposta sarà probabilmente immediata:
“Il cliente.”
Oppure:
“Lo sviluppatore del cliente.”
E sia chiaro: dal punto di vista della divisione tradizionale delle responsabilità ha perfettamente ragione.
Dovrebbe occuparsene lo sviluppatore.
Ma cosa succede se lo sviluppatore non sa farlo?
Cosa succede se non ha esperienza nella profilazione applicativa, nell’analisi SQL o nel debugging di problemi che si manifestano soltanto sotto determinate condizioni?
Cosa succede se il cliente non dispone del budget necessario per commissionare giornate di profiling a uno specialista?
E soprattutto cosa succede quando, non avendo una spiegazione tecnica precisa, la conclusione più semplice diventa inevitabilmente:
“È l’hosting che è lento.”
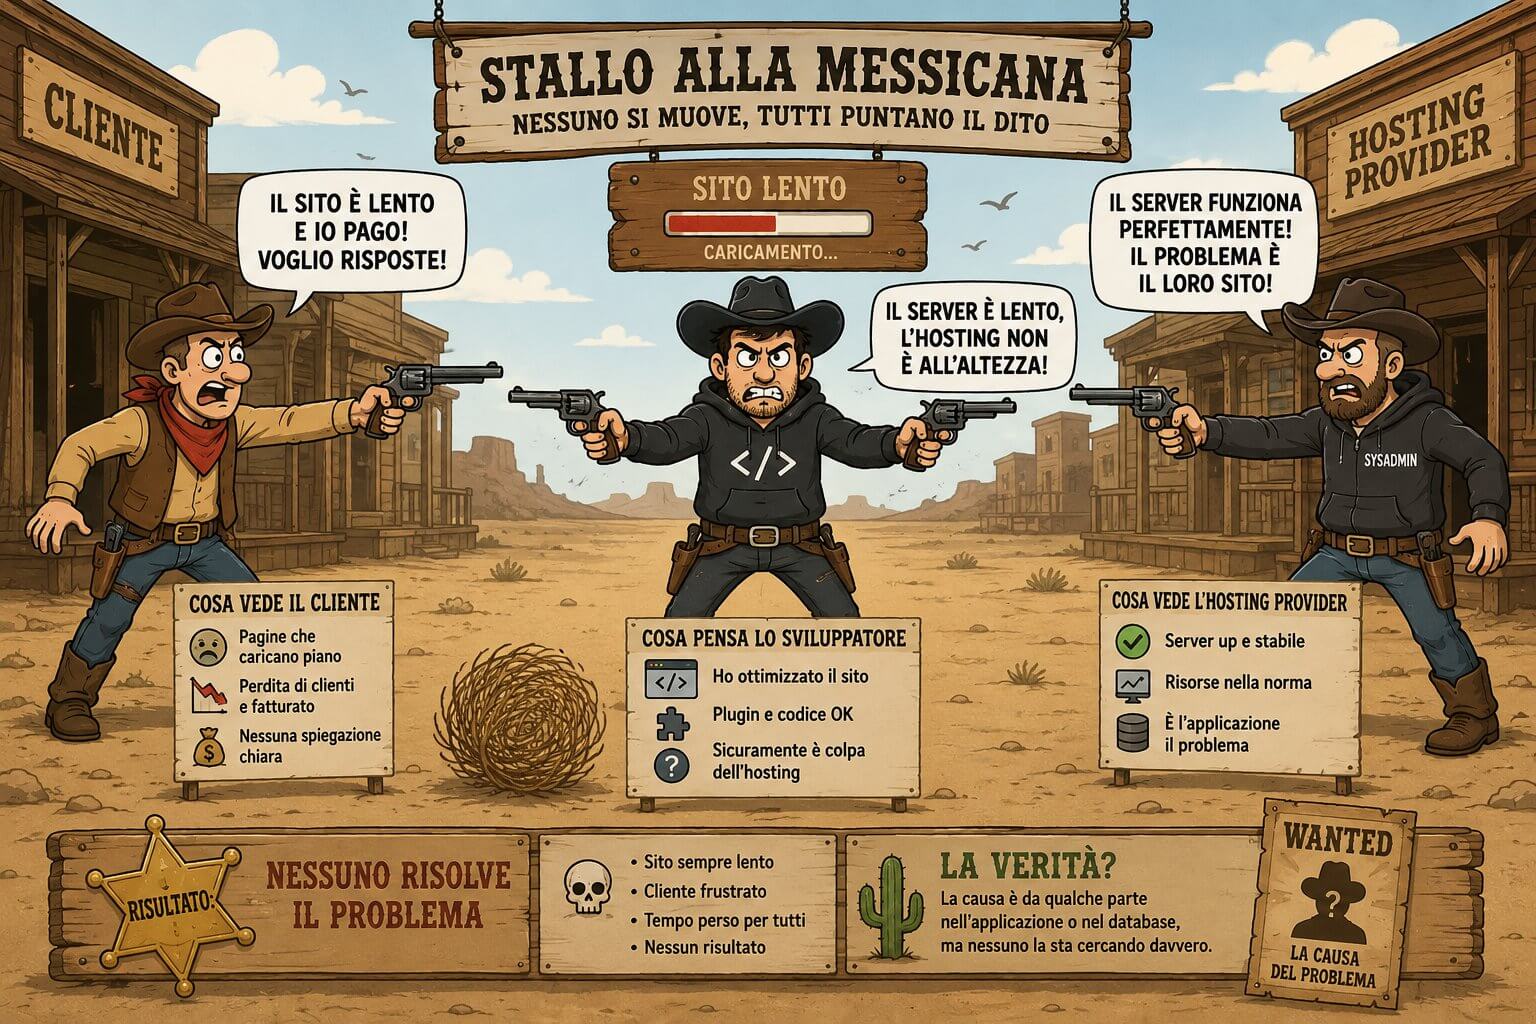
Si arriva a una situazione di stallo in cui nessuno riesce realmente a muoversi.
Il cliente pagante, che non è tecnico, vede il proprio sito lento e si lamenta con lo sviluppatore.
Lo sviluppatore si lamenta con l’Hosting Provider.
L’Hosting Provider controlla server, CPU, RAM e storage e risponde che dal proprio punto di vista tutto funziona correttamente e che il problema è dell’applicativo.
Lo sviluppatore, a sua volta, magari non ha il budget, gli strumenti o le competenze per affrontare un problema di quella complessità.
E il cliente continua ad avere il sito lento.
Passano i giorni. Poi le settimane. Talvolta passa un mese.
A quel punto succede quasi sempre la stessa cosa.
Lo sviluppatore, che nel 90% dei casi è la persona che gode della maggiore fiducia da parte del cliente e che spesso dispone di carta bianca sulla scelta dell’Hosting Provider, decide che è arrivato il momento di cambiare hosting.
Magari senza aver effettuato prima una vera profilazione applicativa.
Magari senza aver fatto, oltre a un esame di coscienza, anche un esame del codice, del database e del comportamento dell’applicazione.
E così un Hosting Provider può perdere un cliente pur non avendo alcuna responsabilità diretta sul problema tecnico che ha generato la lentezza.
Qui però si arriva a un ulteriore paradosso.
Quando un Hosting Provider dice allo sviluppatore o al cliente che il problema è nell’applicativo e non nel server, dovrebbe anche essere in grado di motivare quella risposta.
Non basta dire:
“Gli altri clienti funzionano bene, quindi il problema è sicuramente il vostro sito.”
È un ragionamento plausibile, ma non è una diagnosi.
Bisognerebbe arrivare con numeri, metriche e misurazioni.
Bisognerebbe poter dire che una determinata funzione sta impiegando 2,9 secondi, che una query viene eseguita migliaia di volte, che un PHP worker rimane occupato per ore oppure che una determinata chiamata HTTP sta bloccando la generazione della pagina.
È il principio che abbiamo sempre riassunto con una formula molto semplice:
misurare per decidere.
Il problema è che misurare costa.
Costa tempo e richiede competenze.
E spesso quelle competenze non sono nemmeno presenti internamente all’Hosting Provider, perché un’azienda di hosting nasce normalmente attorno a sistemisti e non necessariamente anche attorno a sviluppatori, DBA o specialisti di profiling applicativo.
Il risultato è quindi uno scaricabarile continuo tra Hosting Provider e sviluppatore.
Il primo sostiene che il server funziona.
Il secondo sostiene che il sito prima funzionava.
E nel mezzo, a farne le spese, rimane sempre il cliente pagante.
È per questo che un Hosting WordPress ottimizzato oggi non è più sufficiente
Da anni sosteniamo che un servizio hosting non possa più essere condotto e fornito esattamente come veniva fatto vent’anni fa.
Oggi fornire hosting per CMS specifici come WordPress, WooCommerce, PrestaShop, Magento, Joomla o Drupal non può significare soltanto mettere a disposizione uno spazio web veloce.
Significa anche essere in grado di affrontare le situazioni difficili quando si presentano.
Significa poter distinguere un problema infrastrutturale da un problema applicativo.
Significa avere la capacità, quando necessario, di scendere di livello e capire cosa sta realmente accadendo dentro l’applicazione.
Qualche nostro competitor potrebbe obiettare che tutto questo ha un costo.
E avrebbe ragione.
Se una profilazione richiede quattro ore di lavoro di un tecnico esperto, non è economicamente sostenibile includerla senza limiti all’interno di un hosting che costa 50 o 100 euro all’anno.
Si andrebbe inevitabilmente in perdita.
Ma è proprio per questo motivo che riteniamo inutile continuare a vendere a poco prezzo qualcosa che, nei momenti in cui serve davvero, non è in grado di risolvere il problema del cliente.
I nostri servizi partono da 27 euro al mese, quindi da cifre che possono essere circa tre volte superiori rispetto a quelle di un hosting economico.
Ma cambia completamente il tipo di servizio, cambia l’approccio e soprattutto cambia la forma mentis nei confronti del cliente e del suo business.
A noi non interessa vendere un piano hosting semplicemente per aggiungere un nuovo cliente e una nuova fattura.
Ci interessa fornire un hosting che funzioni e che, quando si presenta una situazione complessa, riesca realmente a fare la differenza rispetto ad altri fornitori.
Le testimonianze che per noi hanno valore sono quelle del tipo:
“Ho cambiato tre fornitori e nessuno è riuscito a risolvere il problema, fino a quando non ho migrato su Managedserver.it.”
Per arrivare a questo risultato non basta installare NGINX.
Non basta mettere Redis.
Non basta utilizzare storage NVMe o configurare perfettamente PHP-FPM.
Queste tecnologie sono fondamentali e continuano a fare la differenza, ma rappresentano soltanto una parte del problema.
I tempi sono cambiati e anche gli approcci devono cambiare.
Non ha più molto senso, almeno per chi vuole offrire un servizio Managed di alto livello, essere puristi altezzosi della sola sistemistica, rifiutandosi per principio di scendere di livello e di sporcarsi le mani con il codice o con l’applicativo.
Se una macchina Linux sta funzionando perfettamente ma un singolo hook WordPress sta consumando quattro secondi per richiesta, il problema del cliente continua a esistere.
Se MariaDB è configurato perfettamente ma una query senza indice scansiona milioni di righe a ogni apertura di pagina, il sito continua a essere lento.
Se Varnish è configurato correttamente ma una richiesta in MISS entra in un loop infinito e non produce mai una risposta memorizzabile, la cache non potrà salvare il sistema.
Se PayPlug spende quasi tre secondi per stabilire che un metodo di pagamento disabilitato non debba essere mostrato, aggiungere altri core significa semplicemente sprecare più velocemente risorse computazionali su qualcosa che non dovrebbe essere eseguito in quel modo.
Fare Hosting di livello e di alta qualità oggi significa quindi avere una visione complessiva.
Significa conoscere la sistemistica Linux, ma anche saper leggere il comportamento dell’applicazione.
Significa comprendere PHP, SQL, MySQL e MariaDB.
Significa saper effettuare profiling, interpretare metriche, individuare un collo di bottiglia e arrivare possibilmente fino alla causa.
Significa essere in grado non soltanto di dire “il problema non è il server”, ma di aggiungere:
“Il problema è qui, questi sono i numeri che lo dimostrano e questa è la strada per risolverlo.”
Non significa che un Hosting Provider debba trasformarsi gratuitamente nell’agenzia di sviluppo del cliente, né che debba riscrivere interi plugin o temi all’interno del semplice canone mensile.
Significa però avere le competenze necessarie per non fermarsi alla superficie.
Perché il cliente finale, alla fine, non è realmente interessato alla disputa filosofica su dove finisca il lavoro del sistemista e dove inizi quello dello sviluppatore.
Il cliente vede una cosa molto più semplice.
Ha un sito.
Lo sta pagando.
Quel sito deve funzionare.
E quando non funziona, qualcuno deve essere in grado di capire il perché.
È questa, secondo noi, la vera evoluzione dell’Hosting Managed.
Non sostituire la sistemistica con lo sviluppo e nemmeno pretendere che ogni tecnico sappia fare tutto, ma costruire un servizio capace di osservare l’intero stack: infrastruttura, sistema operativo, web server, PHP, database, cache, query SQL, codice e comportamento applicativo.
Il vecchio concetto di Hosting WordPress ottimizzato, inteso semplicemente come server veloce con NGINX, LiteSpeed, Redis o Varnish, non è sbagliato.
È semplicemente diventato insufficiente.
Perché oggi il valore non consiste soltanto nel mettere a disposizione risorse.
Consiste nel sapere cosa sta succedendo quando quelle risorse vengono utilizzate male.
Consiste nel misurare.
Nel capire.
E, quando possibile, nel risolvere.
Tutto il resto appartiene a un modo di fare hosting che il mercato, la complessità dei CMS moderni e le esigenze dei clienti hanno ormai superato.

