
Indice dei contenuti dell'articolo:
Tutto è iniziato con un ticket apparentemente semplice.
Un cliente ci segnalava che il download di alcuni archivi di grandi dimensioni dal proprio sito risultava inspiegabilmente lento quando effettuato tramite browser.
Non si trattava di una differenza marginale, di quelle che possono essere tranquillamente attribuite alla normale variabilità della rete.
Lo stesso archivio statico, di circa 144 MB, veniva scaricato dall’applicazione desktop del cliente in circa 17 secondi, mentre Chrome poteva impiegare oltre 90 secondi.
Da una parte avevamo quindi un throughput nell’ordine degli 8-9 MB/s.
Dall’altra appena 1,5-2 MB/s.
Il server come molti altri di nostri clienti era ospitato presso Hetzner, in Germania, ed eseguiva NGINX con HTTP/2 e HTTP/3 attivi.
Il primo pensiero, davanti a una differenza del genere, è quasi inevitabilmente rivolto alla rete.
MTU?
Path MTU Discovery?
Packet loss?
Firewall?
Filtering UDP?
Routing?
Un problema dell’infrastruttura del datacenter?
Una qualche forma di rate limiting?
Un bug del browser?
Tutte ipotesi assolutamente plausibili.
Il dettaglio che rendeva il caso particolarmente interessante era però un altro: l’applicazione desktop del cliente utilizzava HTTP/1.1 su TCP, mentre Chrome, trovando HTTP/3 annunciato dal server, utilizzava QUIC sopra UDP.
La domanda diventava quindi molto più specifica:
era veramente il protocollo HTTP/3 a rendere il trasferimento quasi dieci volte più lento?
Per rispondere bisognava smettere di confrontare applicazioni differenti e isolare una sola variabile.
Il cliente, fortunatamente, aveva già fatto esattamente questo.
Il cliente aveva già isolato HTTP/2 da HTTP/3
Il primo confronto tra l’applicazione desktop e Chrome era interessante, ma non ancora sufficiente per formulare una diagnosi.
Confrontare due applicazioni differenti significa infatti introdurre moltissime variabili.
L’applicazione Node.js può utilizzare buffer differenti, librerie TLS differenti, strategie differenti per la gestione delle connessioni e perfino meccanismi di download differenti rispetto a Chrome.
Il test realmente significativo doveva utilizzare:
- lo stesso client;
- lo stesso computer;
- la stessa connessione Internet;
- lo stesso binario di Chrome;
- lo stesso hostname;
- lo stesso server;
- lo stesso file;
- lo stesso endpoint HTTPS.
Doveva cambiare soltanto il protocollo.
Negli esempi di questo articolo per le dovute garanzie di privacy del nostro cliente, anonimizzeremo il dominio originale utilizzando:
example.com
e chiameremo il file:
example-package-0.2.3-win-x64.zip
L’URL utilizzato per i benchmark diventa quindi:
https://example.com/downloads/example-package-0.2.3-win-x64.zip
La cosa importante è che si trattava di un file completamente statico servito direttamente da NGINX.
Nessun PHP.
Nessun PHP-FPM.
Nessun WordPress.
Nessun database.
Nessun proxy verso un backend.
Nessun codice applicativo.
Questa caratteristica sarebbe diventata fondamentale perché permetteva di escludere immediatamente un’enorme quantità di possibili colli di bottiglia.
Primo test: disabilitare QUIC e utilizzare HTTP/2
Chrome e Chromium permettono di essere avviati con QUIC completamente disabilitato.
Lo switch è:
--disable-quic
Su Windows, per esempio:
"C:\Program Files\Google\Chrome\Application\chrome.exe" ^
--disable-quic ^
--user-data-dir="%TEMP%\chrome-h2-test" ^
"https://example.com/downloads/example-package-0.2.3-win-x64.zip"
L’utilizzo di:
--user-data-dir
è particolarmente utile durante questo genere di benchmark.
Chrome tende infatti a riutilizzare processi e profili già aperti. Avviare un profilo temporaneo differente permette di ridurre interferenze dovute a sessioni precedenti, cache, stato Alt-Svc e connessioni esistenti.
Su Linux l’equivalente potrebbe essere:
google-chrome
--disable-quic
--user-data-dir=/tmp/chrome-h2-test
"https://example.com/downloads/example-package-0.2.3-win-x64.zip"
Con QUIC disabilitato, Chrome negoziava HTTP/2.
I risultati misurati dal cliente erano:
HTTP/2

7,65 MB/s
9,67 MB/s
Quindi sostanzialmente coerenti con la velocità osservata dal client HTTP/1.1, che saturava la banda della connessione ADSL consumer (noi in smartworking ad esempio utilizziamo una Fastweb da 100 Megabit).
Fin qui tutto normale.
Secondo test: forzare HTTP/3 sullo stesso Chrome
A questo punto veniva chiusa la precedente istanza e avviato nuovamente lo stesso binario Chrome, questa volta forzando QUIC verso lo specifico origin.
Lo switch utilizzato è:
--origin-to-force-quic-on=example.com:443
È importante fare attenzione alla sintassi.
A volte questo parametro viene rappresentato informalmente in documentazione o esempi come:
--origin-to-force-quic-on=[example.com:443]
ma le parentesi quadre indicano normalmente un placeholder e non vanno passate letteralmente.
La sintassi effettiva è:
--origin-to-force-quic-on=example.com:443
Per rendere il test ancora più esplicito possiamo utilizzare anche:
--enable-quic
ottenendo:
"C:\Program Files\Google\Chrome\Application\chrome.exe" ^
--enable-quic ^
--origin-to-force-quic-on=example.com:443 ^
--user-data-dir="%TEMP%\chrome-h3-test" ^
"https://example.com/downloads/example-package-0.2.3-win-x64.zip"
Su Linux:
google-chrome
--enable-quic
--origin-to-force-quic-on=example.com:443
--user-data-dir=/tmp/chrome-h3-test
"https://example.com/downloads/example-package-0.2.3-win-x64.zip"
Stesso computer.
Stesso Chrome.
Stesso server.
Stesso file.
Stessa connessione.
Questa volta però i risultati diventavano molto diversi e molto peggiori:
HTTP/3

1,64 MB/s
1,95 MB/s
Una differenza enorme, da 10 Megabyte al secondo (che sarebbero certamente aumentati con una connessione ADSL o fibra più veloce) ad una connessione strozzata a meno di 2 Megabyte al secondo.
Il test decisivo: H2 → H3 → H2
Il cliente aveva fatto anche un’altra cosa metodologicamente molto corretta.
Le prove non erano state eseguite in due blocchi separati, per esempio dieci benchmark HTTP/2 al mattino e dieci HTTP/3 mezz’ora più tardi.
Erano state interlacciate.
La sequenza era:
HTTP/2
HTTP/3
HTTP/2
I risultati:
--disable-quic

HTTP/2
7,65 MB/s
9,67 MB/s
poi:
--enable-quic
--origin-to-force-quic-on=example.com:443

HTTP/3
1,64 MB/s
1,95 MB/s
e subito dopo:
--disable-quic

HTTP/2
7,55 MB/s
9,68 MB/s
In forma ancora più evidente:
HTTP/2    ~8-10 MB/s

HTTP/3    ~1,5-2 MB/s

HTTP/2    ~8-10 MB/s
Questa sequenza iniziava a rendere poco credibile la spiegazione basata su una generica congestione Internet.
Sarebbe infatti necessario supporre che la connessione diventasse improvvisamente cinque o sei volte più lenta esattamente quando veniva attivato QUIC, per poi tornare immediatamente veloce quando si ritornava a HTTP/2.
Possibile in teoria.
Molto improbabile quando il risultato è riproducibile.
Verificare il protocollo in Chrome DevTools
Quando si eseguono benchmark di questo tipo è comunque importante non fidarsi ciecamente dei flag utilizzati per avviare il browser.
Chrome DevTools permette di visualizzare il protocollo realmente utilizzato.
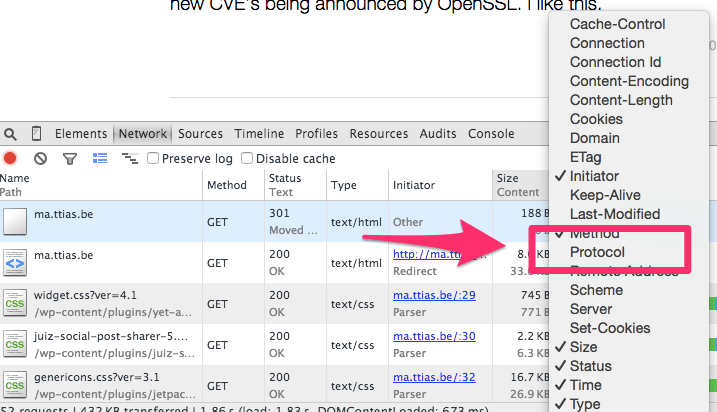
Basta aprire:
F12
→ Network
e abilitare la colonna:
Protocol
Nel primo test bisogna verificare la presenza di:
h2
mentre nel secondo:
h3
Questo controllo evita di interpretare come HTTP/3 una richiesta che, per qualsiasi ragione, abbia effettuato fallback verso HTTP/2.
Prima ipotesi: un problema UDP sulla rete Hetzner ?
HTTP/2 utilizza TCP.
HTTP/3 utilizza QUIC sopra UDP.
Era quindi naturale iniziare a indagare tutto ciò che avrebbe potuto penalizzare UDP lasciando sostanzialmente inalterato TCP.
Il server era ospitato sull’infrastruttura Hetzner in Germania e abbiamo iniziato a prendere in considerazione un eventuale comportamento specifico del percorso di rete.
Tra le prime ipotesi:
- packet loss UDP;
- filtering UDP;
- UDP policing;
- routing differente;
- problemi su firewall intermedi;
- code o shaping differenti per UDP e TCP.
Una piccola quantità di packet loss può incidere in maniera significativa sul congestion control.
HTTP/3 non è semplicemente “HTTP/2 trasportato sopra UDP”: QUIC implementa direttamente molte funzionalità che tradizionalmente appartengono allo stack TCP, inclusi acknowledgements, controllo di congestione e ritrasmissioni.
Il comportamento di un flusso QUIC in presenza di loss può quindi essere sensibilmente differente.
Seconda ipotesi: MTU e Path MTU Discovery
Subito dopo abbiamo considerato uno dei classici problemi delle connessioni UDP: la MTU.
Un percorso con MTU inferiore al previsto, un tunnel intermedio o una gestione non corretta dei messaggi ICMP Packet Too Big possono provocare comportamenti difficili da diagnosticare.
TCP dispone da decenni di un ecosistema molto maturo intorno a MSS e Path MTU.
QUIC deve invece gestire datagrammi UDP e packetizzazione secondo dinamiche proprie.
Sono quindi diventati sospetti:
MTU
PMTU
ICMP filtering
UDP fragmentation
tunnel
VLAN/VXLAN
Durante una diagnosi del genere può essere utile osservare direttamente il traffico:
tcpdump -ni any udp port 443
e confrontarlo con:
tcpdump -ni any tcp port 443
Ma anche qui mancava qualcosa.
Il throughput HTTP/3 non sembrava semplicemente “instabile”.
Sembrava quasi fermarsi sistematicamente intorno a un valore preciso.
Socket buffer e statistiche UDP del kernel
La ricerca è quindi proseguita nello stack Linux.
Un server HTTP/3 ad alte prestazioni dipende anche dalla corretta gestione dei socket UDP.
Tra i primi controlli:
netstat -su
oppure:
nstat -az
cercando valori quali:
UdpInErrors
UdpRcvbufErrors
UdpSndbufErrors
e successivamente i buffer del kernel:
sysctl net.core.rmem_max
sysctl net.core.wmem_max
sysctl net.core.rmem_default
sysctl net.core.wmem_default
Tutte ipotesi tecnicamente valide.
Ma continuava a esserci quel numero.
Circa 1,6 MB/s.
Il numero che iniziava a sembrare troppo preciso: 64 KB
Durante l’analisi abbiamo iniziato a guardare più attentamente la configurazione HTTP/3 di NGINX.
Esiste una direttiva chiamata:
http3_stream_buffer_size
La documentazione ufficiale la descrive come la dimensione del buffer utilizzato per leggere e scrivere gli stream QUIC.
Il default è:
http3_stream_buffer_size 64k;
e la direttiva può essere impostata nei contesti:
http
server
Il valore di 64 KB diventava immediatamente interessante.
Un maintainer NGINX ci ha spiegato che NGINX limita la quantità di byte non acknowledged su un singolo stream HTTP/3 in funzione di http3_stream_buffer_size.
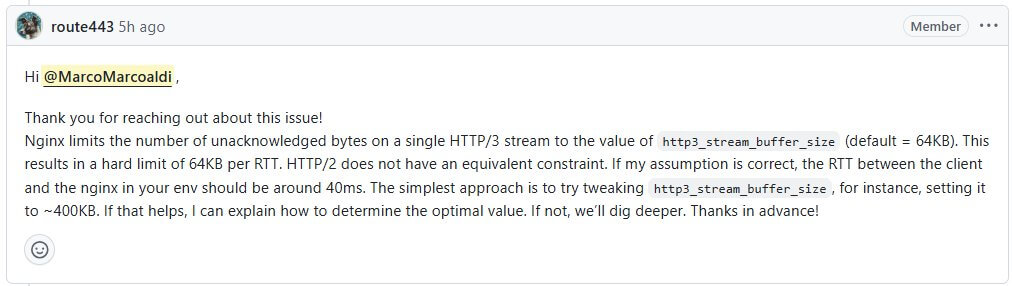
In termini pratici questo può trasformarsi, in determinate condizioni, in un limite nell’ordine di:
buffer / RTT
Immaginiamo un RTT di circa:
40 ms
Con il buffer predefinito:
64 KB
otteniamo:
64 KB / 0,040 s ≈ 1,6 MB/s
Ed era esattamente l’ordine di grandezza dei nostri benchmark:
1,64 MB/s
1,95 MB/s
A quel punto il problema smetteva di sembrare casuale.
Il concetto di Bandwidth-Delay Product
Il principio è lo stesso che chi lavora da anni con TCP conosce attraverso il Bandwidth-Delay Product.
Se vogliamo mantenere una certa quantità di banda costantemente occupata dobbiamo avere abbastanza dati “in volo” durante il tempo necessario perché gli acknowledgement tornino al mittente.
Supponiamo di voler raggiungere:
10 MB/s
con:
RTT = 40 ms
Il BDP è:
10 MB/s × 0,040 s
ovvero:
0,4 MB
circa:
400 KB
Un buffer da 64 KB è quindi molto inferiore alla quantità di dati che dovrebbe poter rimanere contemporaneamente in volo per saturare quel percorso.
Non a caso il suggerimento ricevuto era di provare un valore nell’ordine di:
http3_stream_buffer_size 400k;
o, più comodamente:
http3_stream_buffer_size 512k;
Per avere margine potevamo utilizzare:
http3_stream_buffer_size 1m;
L’importanza del BDP nel dimensionamento di finestre e buffer su percorsi ad alta banda e latenza non è nuova: è uno dei principi fondamentali del throughput sulle reti WAN.
C’era inoltre un dettaglio curioso nella documentazione tecnica pubblicata dalla stessa NGINX: nei propri benchmark delle performance QUIC con RTT e BDP elevati, NGINX ha utilizzato:
http3_stream_buffer_size 50m;
quindi un valore enormemente superiore al default di 64 KB.
Un problema già visto da altri
Nel frattempo avevamo trovato anche una issue pubblica NGINX estremamente simile, la #1498 ( https://github.com/nginx/nginx/issues/1498), una issue relativamente recente ed attuale tenendo conto che siamo il 1° Settembre 2026 e la issue è stata aperta il 23 Giugno 2026, circa 2 mesi fa.
In quel caso veniva servito direttamente da NGINX un file statico da 1 GB.
I risultati erano circa:
HTTP/2    ~30 MB/s
HTTP/3    ~3,2 MB/s
Stesso server, stesso network path, nessun upstream applicativo.
Anche lì erano stati verificati UDP, GSO e altri aspetti della rete senza trovare una spiegazione immediata. La issue risultava in analisi da parte del progetto NGINX.
Il parallelismo con il nostro caso era evidente.
Il nostro rapporto era circa:
9 MB/s vs 1,8 MB/s
quello della issue:
30 MB/s vs 3,2 MB/s
Non era necessariamente lo stesso bug, ma certamente la stessa classe di fenomeno.
Modifichiamo http3_stream_buffer_size
A quel punto sembrava di aver trovato la strada giusta.
La configurazione del virtual host principale conteneva, in forma semplificata:
server {
listen 192.0.2.10:443 quic reuseport;
listen 192.0.2.10:443 ssl http2;

```
server_name example.com;

...

quic_gso on;
http3_stream_buffer_size 16m;

...
```

}
Avevamo utilizzato volutamente:
16m
un valore enormemente superiore ai 400-500 KB teoricamente necessari.
Non perché 16 MB fossero il valore corretto da utilizzare in produzione, ma perché volevamo una prova quasi binaria.
Se il problema fosse stato il buffer, passando da:
64 KB
a:
16 MB
il cambiamento avrebbe dovuto essere evidente.
Abbiamo eseguito:
nginx -t
seguito dal reload.
Nuovo benchmark.
HTTP/3 continuava ad andare praticamente alla stessa velocità.
Circa dieci volte più lentamente di HTTP/2.
Sembrava che l’ipotesi fosse sbagliata.
E invece era proprio in quel momento che il caso diventava più interessante.
Perché 16m non cambiava nulla?
La configurazione conteneva due virtual host HTTPS sulla stessa coppia IP:porta.
In forma estremamente semplificata:
server {
listen 192.0.2.10:443 quic;
listen 192.0.2.10:443 ssl http2;

```
server_name www.example.com;

...
```

}
e successivamente:
server {
listen 192.0.2.10:443 quic reuseport;
listen 192.0.2.10:443 ssl http2;

```
server_name example.com;

http3_stream_buffer_size 16m;

...
```

}
La direttiva:
http3_stream_buffer_size 16m;
era presente esclusivamente nel secondo server {}.
Normalmente, ragionando in termini di HTTP tradizionale e virtual hosting, viene spontaneo pensare:
La richiesta arriva per
example.com, quindi NGINX seleziona il server block diexample.come utilizza i suoi parametri.
Ma QUIC introduce un problema temporale.
La connessione deve essere inizializzata prima che esista una normale richiesta HTTP completamente processata.
Ed è qui che abbiamo deciso di smettere di ragionare soltanto sulla documentazione e andare direttamente a leggere il codice sorgente di NGINX.
Leggere il sorgente NGINX: dove nasce realmente la connessione HTTP/3
La funzione interessante si trova in:
src/http/ngx_http_request.c
all’interno di:
ngx_http_init_connection()
Questa è una funzione molto importante perché rappresenta uno dei primi punti nei quali NGINX associa una nuova connessione al sottosistema HTTP.
Il codice determina innanzitutto la configurazione relativa all’indirizzo e alla porta sulla quale la connessione è arrivata.
A un certo punto troviamo una riga particolarmente significativa:
hc->conf_ctx = hc->addr_conf->default_server->ctx;
Il commento immediatamente precedente nel sorgente NGINX è altrettanto esplicito: in questa fase viene utilizzata la configurazione del default server per quella coppia address:port.
Questo significa che, in quel preciso momento, NGINX non è ancora partito dalla configurazione del virtual host che intuitivamente associamo al nome richiesto.
Sta lavorando con il contesto del:
default_server
associato al listener.
Fin qui potrebbe ancora non essere un problema.
La parte decisiva arriva poche istruzioni dopo.
Sempre nella stessa funzione troviamo la gestione specifica HTTP/3:
if (hc->addr_conf->quic) {
ngx_http_v3_init_stream(c);
return;
}
La sequenza logica diventa quindi:
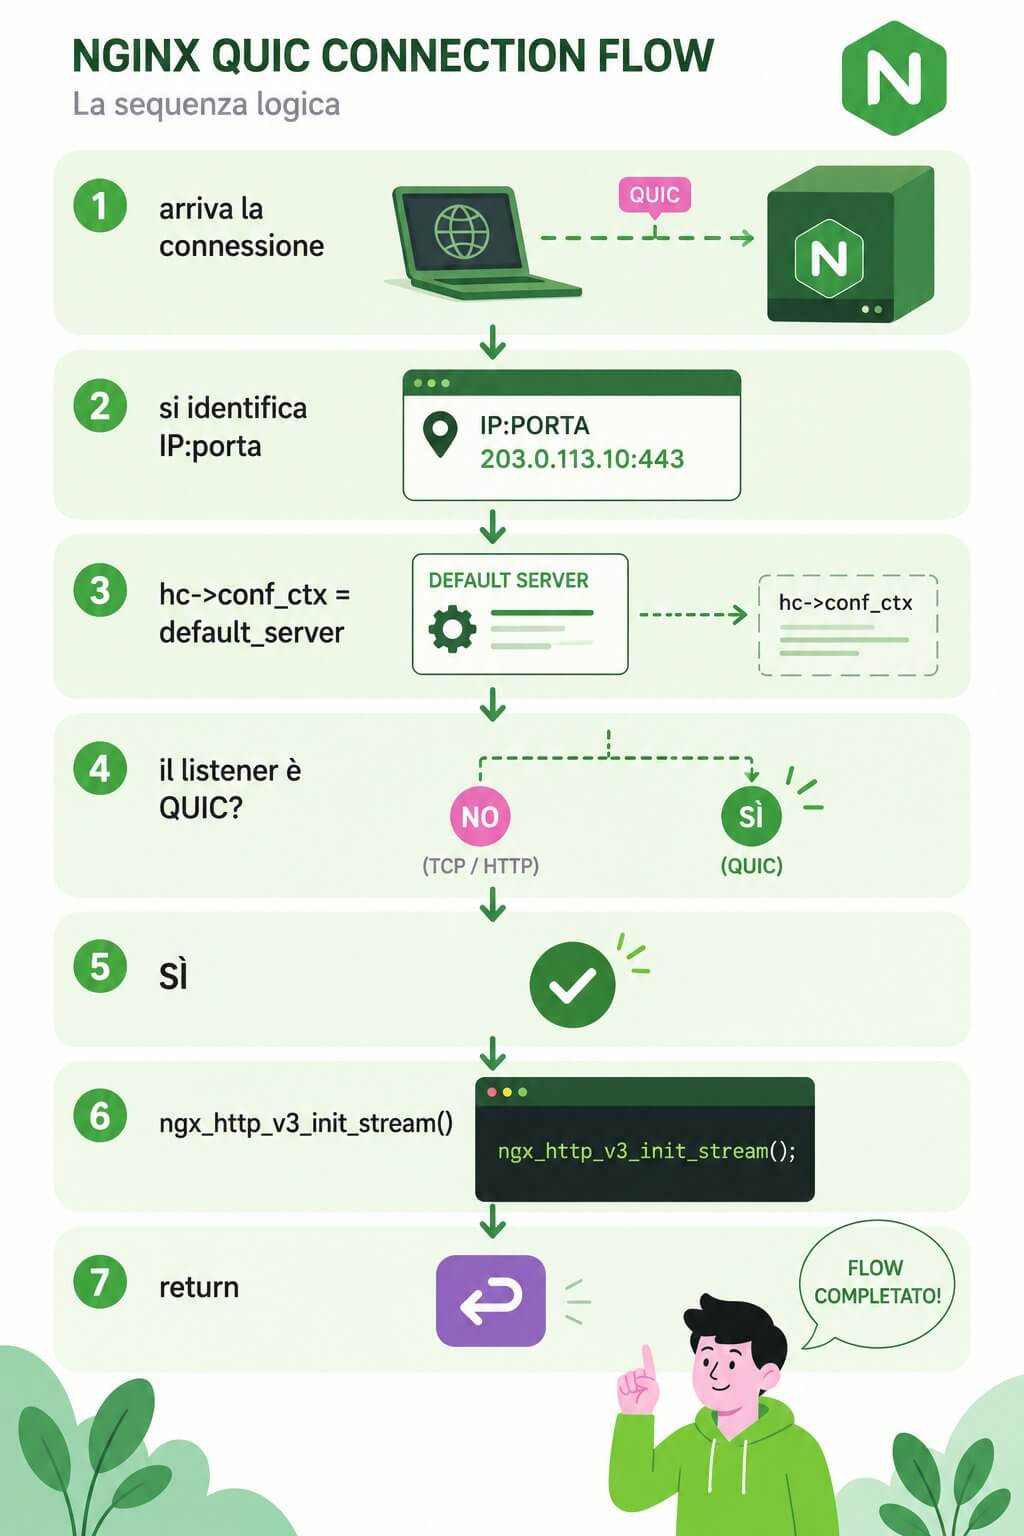
Questo return è particolarmente importante.
NGINX non prosegue lungo il normale percorso di attesa e parsing della richiesta HTTP.
Se la connessione è QUIC, entra immediatamente nell’inizializzazione HTTP/3.
Entriamo dentro ngx_http_v3_init_stream()
A questo punto abbiamo seguito il flusso nel file:
src/http/v3/ngx_http_v3_request.c
La funzione:
ngx_http_v3_init_stream()
riceve la connessione appena inizializzata.
All’interno troviamo un altro passaggio decisivo:
h3scf = ngx_http_get_module_srv_conf(hc->conf_ctx,
ngx_http_v3_module);
e poco dopo:
ngx_quic_run(c, &h3scf->quic);
Proviamo a tradurlo senza perdersi nei dettagli dell’API interna di NGINX.
h3scf è la server configuration del modulo HTTP/3.
Da dove viene recuperata?
Da:
hc->conf_ctx
Ma pochi istanti prima quel hc->conf_ctx era stato impostato a:
default_server->ctx
Quindi il percorso diventa:
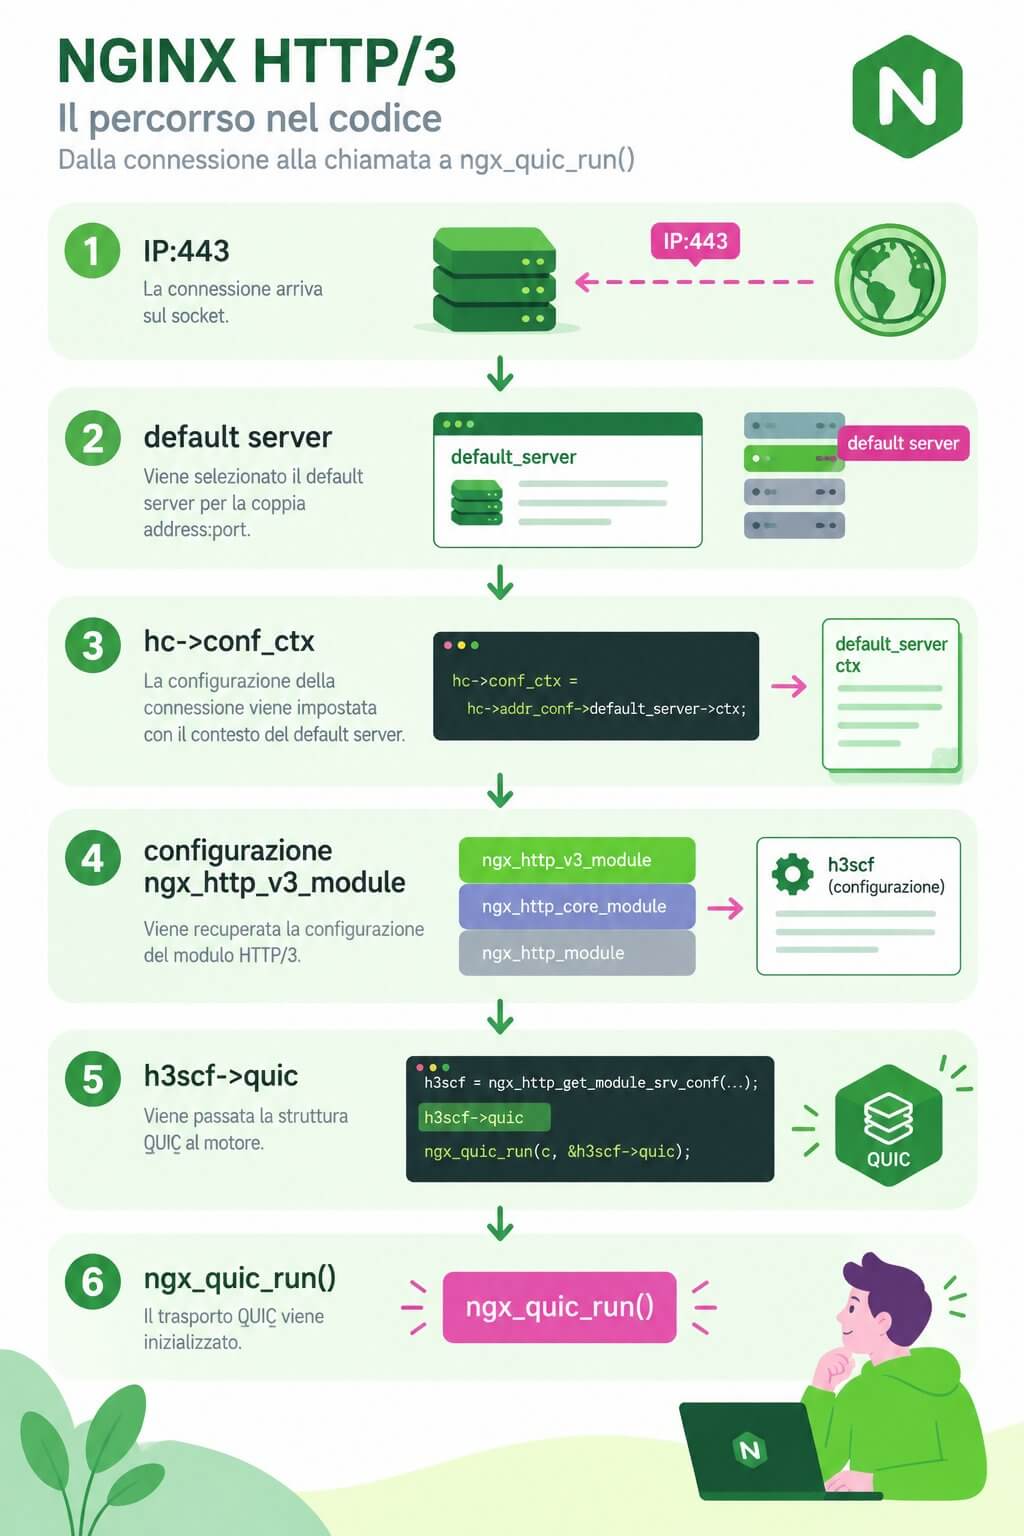
È qui che la nostra configurazione ha finalmente iniziato ad avere senso.
Il parametro:
http3_stream_buffer_size 16m;
era presente nel secondo virtual host.
Ma la connessione QUIC veniva inizializzata utilizzando il contesto disponibile prima della normale selezione del virtual host HTTP basata sulla richiesta.
Il sorgente mostra inoltre che, quando vengono successivamente creati gli stream QUIC figli, NGINX può ereditare il contesto della connessione HTTP/3 parent dopo la gestione del server name; ma a quel punto il trasporto QUIC iniziale è già stato avviato tramite ngx_quic_run().
Ed era proprio questo il dettaglio che stavamo cercando.
Andiamo ancora più in profondità: dove viene definito il default da 64 KB?
A questo punto mancava un’ultima verifica.
Dove viene realmente impostato:
65536
come valore predefinito?
La risposta è in:
src/http/v3/ngx_http_v3_module.c
La definizione della direttiva associa:
http3_stream_buffer_size
direttamente a:
quic.stream_buffer_size
all’interno della configurazione HTTP/3.
Durante la creazione della configurazione il valore viene inizialmente marcato come non impostato.
Successivamente, nella funzione di merge delle configurazioni, troviamo il valore:
65536
come default finale.
Ovvero:
65536 byte = 64 KiB
Il sorgente confermava quindi esattamente ciò che riportava la documentazione:
http3_stream_buffer_size 64k;
Ma soprattutto mostrava che quel valore finiva direttamente nella struttura:
quic.stream_buffer_size
che veniva successivamente passata al motore QUIC.
Avevamo finalmente ricostruito tutto il percorso.
Semplificando molto il percorso completo nel codice NGINX è :
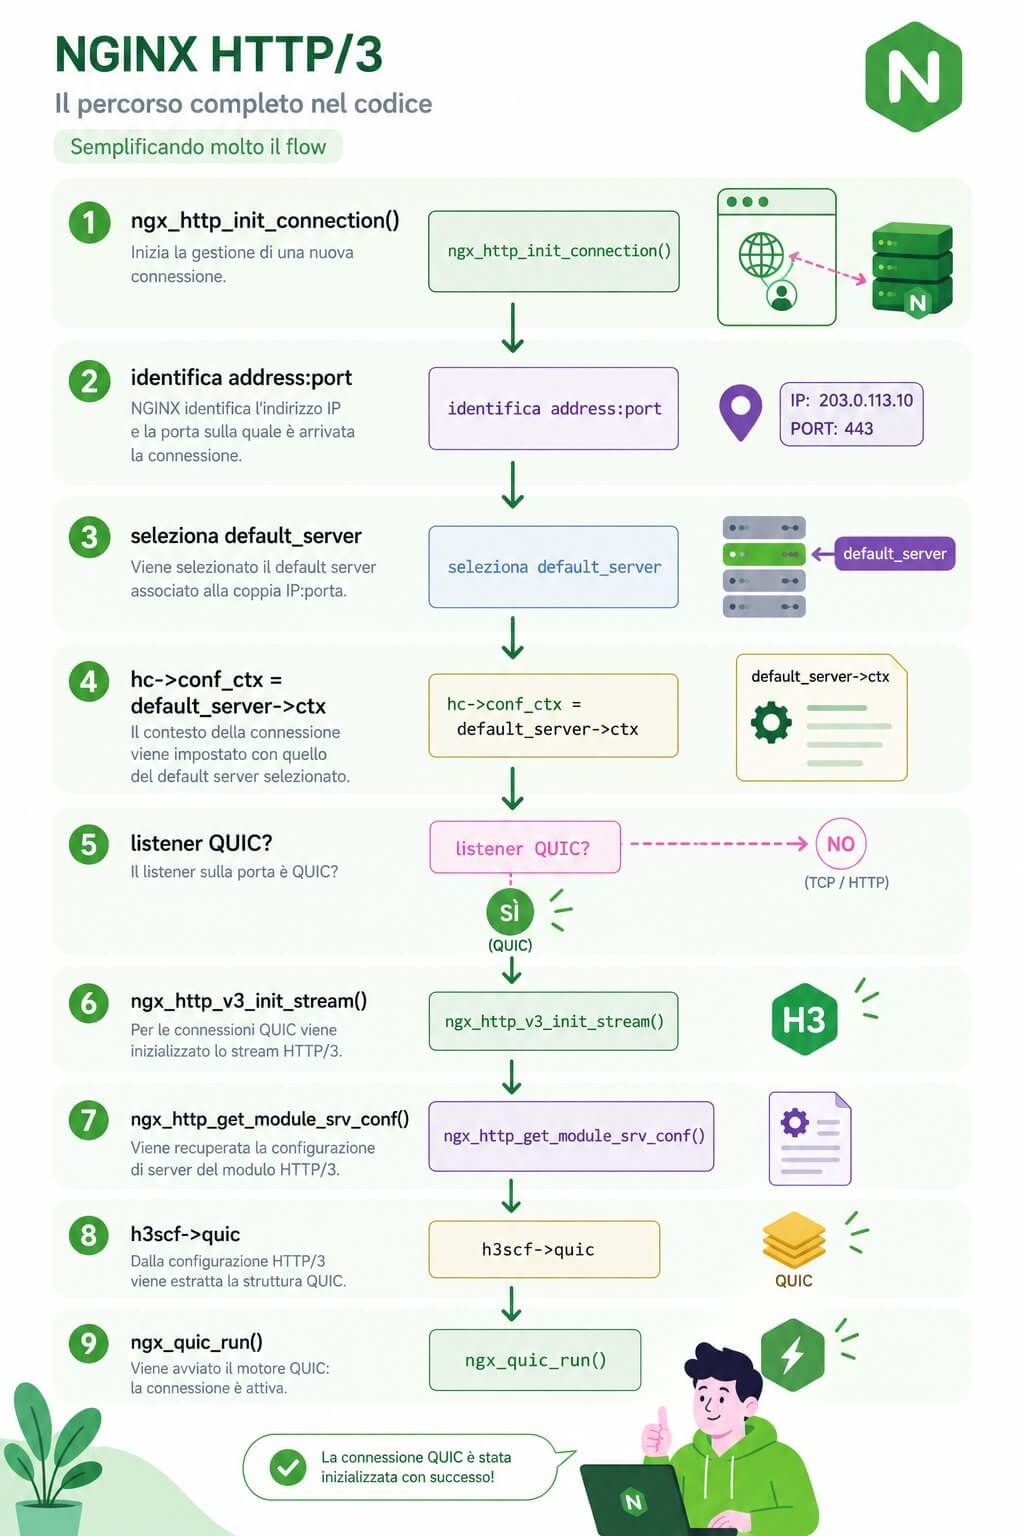
La cosa importante non è tanto conoscere a memoria queste funzioni.
È comprendere l’ordine temporale degli eventi.
Con HTTP/3 non possiamo sempre ragionare come se prima arrivasse una normale richiesta HTTP completa e soltanto dopo venisse selezionato tutto il virtual host.
Alcuni parametri necessari al trasporto QUIC devono essere disponibili molto prima.
La soluzione: spostare il parametro nel contesto http
A questo punto abbiamo modificato la configurazione.
Invece di avere:
server {
server_name example.com;

```
http3_stream_buffer_size 16m;
```

}
abbiamo spostato il parametro nel blocco globale:
http {

```
http3_stream_buffer_size 1m;

...
```

}
La direttiva supporta ufficialmente entrambi i contesti:
http
server
Utilizzarla a livello http {} aveva però un vantaggio fondamentale nel nostro scenario: tutti i virtual server ereditavano lo stesso valore e non esisteva più alcuna ambiguità durante l’inizializzazione QUIC associata al listener.
Abbiamo verificato la configurazione effettivamente caricata con:
nginx -T 2>&1 | grep -n http3_stream_buffer_size
quindi:
nginx -t
e:
systemctl reload nginx
Nuovo benchmark.
Questa volta il risultato è cambiato immediatamente.
HTTP/3 non era più inchiodato intorno agli 1,5-2 MB/s.
Il throughput tornava comparabile a quello ottenuto attraverso HTTP/2.
Il problema era risolto.
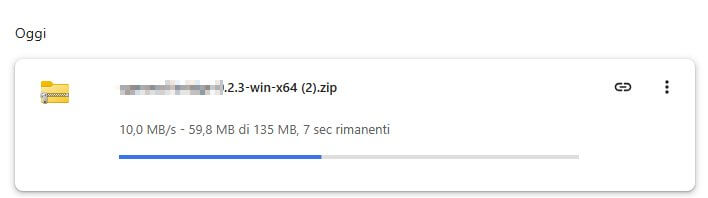
Anche Chrome riusciva a saturare la connessione della nostra connessione Fastweb a 100 Megabit.
Perché la prima modifica sembrava corretta ma non lo era
Questa è probabilmente la parte più interessante dell’intero caso.
La configurazione:
server {
server_name example.com;

```
http3_stream_buffer_size 16m;
```

}
non era sintatticamente sbagliata.
NGINX la accettava.
nginx -t restituiva correttamente:
syntax is ok
test is successful
La direttiva è ufficialmente permessa nel contesto server.
Eppure, nella particolare topologia con più virtual host QUIC sullo stesso socket, non stava influenzando la fase della connessione che ci interessava.
Non era quindi un errore di sintassi.
Era un errore di comprensione del lifecycle della connessione.
Ed è esattamente qui che leggere il codice sorgente può fare la differenza.
Non impostate 16 MB senza motivo
Nel nostro test avevamo utilizzato:
http3_stream_buffer_size 16m;
esclusivamente come esperimento.
Non significa che 16 MB rappresentino il valore ottimale.
Il parametro dovrebbe idealmente essere dimensionato rispetto al bandwidth-delay product del tipo di connessioni che vogliamo servire.
Con:
10 MB/s
40 ms RTT
abbiamo:
10 × 0,040 = 0,4 MB
quindi circa 400 KB.
Un valore come:
http3_stream_buffer_size 512k;
potrebbe già essere sufficiente.
Oppure si può utilizzare un margine:
http3_stream_buffer_size 1m;
Naturalmente non esiste un numero universalmente corretto.
Consideriamo per esempio un server che debba sostenere:
50 MB/s
verso client con:
80 ms RTT
Il BDP diventa:
50 × 0,080 = 4 MB
In quel caso un buffer da 512 KB sarebbe nuovamente insufficiente per sfruttare completamente il percorso.
Il valore corretto dipende quindi da:
throughput desiderato
×
RTT atteso
con un opportuno margine operativo.
Una checklist diagnostica pratica
Se vi trovate davanti a HTTP/3 molto più lento di HTTP/2, non partirei modificando dieci parametri contemporaneamente.
La sequenza che questo caso ci ha suggerito è più simile alla seguente.
Prima isolare il protocollo:
H2 → H3 → H2
Poi verificare che il file sia realmente statico.
Successivamente controllare RTT:
ping example.com
e confrontarlo con il throughput osservato.
Se, per esempio, avete:
RTT ≈ 40 ms
HTTP/3 ≈ 1,5 MB/s
il default da 64 KB diventa immediatamente sospetto.
Controllare quindi:
http3_stream_buffer_size
e soprattutto dove è stato configurato.
Con più virtual host QUIC sullo stesso socket, verificare quale sia il default server e considerare seriamente di impostare i parametri QUIC condivisi nel contesto:
http {}
Soltanto se il buffer non modifica il comportamento passerei alle altre possibili ipotesi:
MTU / PMTU
UDP packet loss
firewall
UDP policing
routing
GSO
GRO
socket buffer
NIC
kernel
congestion control
Questa sequenza evita di perdere ore nel networking quando il collo di bottiglia è invece nella configurazione del trasporto HTTP/3.
HTTP/3 non è automaticamente sempre più veloce di HTTP/2
Uno degli errori più frequenti nell’ottimizzazione web consiste nell’associare la versione più recente di un protocollo a un incremento automatico delle prestazioni.
HTTP/3 offre vantaggi tecnologici importanti.
QUIC evita l’head-of-line blocking tra stream a livello di trasporto tipico di TCP, integra il trasporto sicuro con TLS, consente connection migration ed è stato progettato pensando anche a reti moderne, mobili e soggette a variazioni.
Ma nessuno di questi vantaggi significa:
HTTP/3 > HTTP/2
in ogni singolo benchmark.
Il modulo HTTP/3 di NGINX viene ancora esplicitamente descritto dalla documentazione ufficiale come experimental, con il relativo “caveat emptor”.
Inoltre la performance di QUIC dipende da elementi che nel mondo HTTP/2 potevamo spesso ignorare:
- buffer per stream;
- congestion control QUIC;
- RTT;
- packet loss;
- UDP offloading;
- comportamento del kernel;
- dimensionamento del BDP;
- implementazione specifica del server.
NGINX stesso ha pubblicato benchmark nei quali il tuning del congestion control QUIC produce differenze molto importanti al variare di RTT e BDP, utilizzando per quelle prove un http3_stream_buffer_size molto superiore al default.
Il valore del debugging per esclusione
Questo caso è anche un buon esempio di come dovrebbe essere affrontato un problema di performance.
All’inizio avevamo una descrizione molto generica:
“Da browser i file vengono scaricati lentamente.”
Una segnalazione così potrebbe portare in decine di direzioni.
La prima trasformazione importante è stata:
“Chrome è lento, l’applicazione desktop no.”
Poi:
“HTTP/1.1 e HTTP/2 sono veloci, HTTP/3 è lento.”
Poi ancora:
“Il file è statico e il comportamento segue esclusivamente il protocollo.”
Infine:
“Il throughput di HTTP/3 corrisponde sorprendentemente bene a 64 KB per RTT.”
Ogni test eliminava un pezzo del problema.
È la differenza tra cambiare configurazioni casualmente e fare diagnosi.
E soprattutto: non fidarsi solamente della configurazione che vediamo
Il secondo insegnamento è ancora più interessante.
Avevamo impostato:
http3_stream_buffer_size 16m;
Guardando il virtual host sembrava tutto corretto.
Il dominio richiesto era quello.
La direttiva era presente.
NGINX aveva effettuato il reload senza errori.
Ma il risultato non cambiava.
A quel punto avremmo potuto concludere:
“Quindi
http3_stream_buffer_sizenon c’entra.”
Sarebbe stata una conclusione sbagliata.
Leggere:
src/http/ngx_http_request.c
e:
src/http/v3/ngx_http_v3_request.c
ha mostrato qualcosa che la semplice lettura di nginx.conf non rende evidente.
La sequenza era:
default server del socket
↓
inizializzazione HTTP/3
↓
lettura della configurazione QUIC
↓
ngx_quic_run()
Solo dopo entrano pienamente in gioco gli ulteriori meccanismi di associazione del server name e degli stream.
Il problema non era quindi che il valore fosse troppo basso.
Era che il valore che pensavamo di aver modificato non era quello utilizzato nel momento decisivo dell’inizializzazione della connessione QUIC.
La configurazione finale
In un’infrastruttura con più virtual host HTTP/3 sulla stessa porta, per parametri che vogliamo rendere comuni preferiamo quindi una configurazione del genere:
http {

```
http3_stream_buffer_size 1m;

...

server {
    listen 192.0.2.10:443 quic reuseport;
    listen 192.0.2.10:443 ssl;

    server_name www.example.com;

    ...
}

server {
    listen 192.0.2.10:443 quic reuseport;
    listen 192.0.2.10:443 ssl;

    server_name example.com;

    ...
}
```

}
Il valore 1m è soltanto esemplificativo e va dimensionato in funzione del caso reale.
La cosa fondamentale è che il parametro sia disponibile coerentemente al momento dell’inizializzazione QUIC.
Lo stesso ragionamento merita attenzione anche per altre direttive di server configuration QUIC, come quic_gso, perché nel sorgente anch’essa è memorizzata nella struttura di configurazione QUIC e il default è off.
Non significa che ogni direttiva debba obbligatoriamente essere spostata nel blocco globale.
Significa invece che, quando diversi virtual host condividono lo stesso listener QUIC, bisogna comprendere quali informazioni vengano necessitate durante le primissime fasi della connessione.
Conclusioni
Siamo partiti da un cliente che scaricava un archivio statico a circa:
1,5-2 MB/s
con Chrome.
La stessa risorsa attraverso HTTP/1.1 o HTTP/2 raggiungeva:
8-10 MB/s
Abbiamo inizialmente sospettato:
MTU
PMTU
firewall
routing UDP
packet loss
socket buffer
GSO
NIC
kernel
Hetzner
Tutte ipotesi perfettamente legittime.
Il test interlacciato eseguito con lo stesso Chrome aveva però dimostrato qualcosa di estremamente preciso:
H2 veloce
H3 lento
H2 nuovamente veloce
Il throughput HTTP/3 era inoltre sorprendentemente compatibile con il limite prodotto da:
64 KB / RTT
La documentazione NGINX confermava che:
http3_stream_buffer_size 64k;
è il valore predefinito.
Il codice sorgente confermava a sua volta che quel valore viene memorizzato nella configurazione QUIC e che il default implementato durante il merge è effettivamente 65536 byte.
Ma il passaggio realmente decisivo è arrivato analizzando il lifecycle della connessione.
In ngx_http_init_connection() NGINX parte dal default_server associato alla coppia address:port e, quando riconosce un listener QUIC, richiama immediatamente ngx_http_v3_init_stream().
Dentro quest’ultima funzione viene recuperata la configurazione HTTP/3 dal contesto disponibile e la struttura QUIC viene passata a ngx_quic_run().
Ecco perché impostare un enorme:
http3_stream_buffer_size 16m;
soltanto nel secondo virtual host non aveva cambiato il risultato.
Spostando invece la configurazione nel contesto globale:
http {
http3_stream_buffer_size 1m;
}
il limite è scomparso e HTTP/3 ha iniziato finalmente a trasferire il file a una velocità comparabile a HTTP/2.
Il caso è interessante non perché insegni semplicemente ad aumentare un buffer.
La vera lezione è un’altra.
Una configurazione sintatticamente corretta non è necessariamente applicata nella fase del protocollo nella quale immaginiamo che venga applicata.
Quando si lavora con tecnologie come QUIC, TLS, HTTP/2 e HTTP/3, conoscere soltanto le direttive di configurazione può non essere sufficiente.
A volte bisogna seguire la connessione fino dentro il sorgente.
Ed è proprio lì, tra un:
default_server->ctx
e una chiamata a:
ngx_quic_run()
che abbiamo trovato la differenza tra un download da un minuto e mezzo e uno da pochi secondi.

