
Indice dei contenuti dell'articolo:
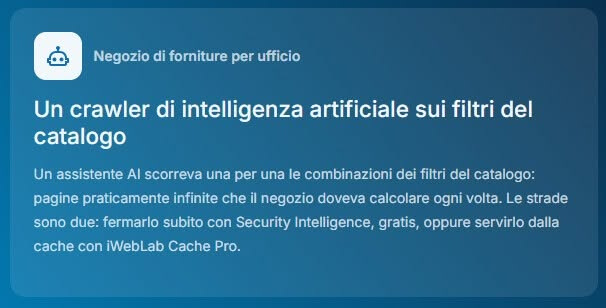
Leggo la comunicazione di un hosting italiano, nostro concorrente, che nell’annuncio del suo nuovo sito web descrive un crawler di intelligenza artificiale intento a esplorare i filtri di un catalogo. Il negozio, ci viene raccontato, doveva calcolare ogni volta “pagine praticamente infinite”. Poi arriva la formula commerciale: fermare il bot oppure servirgli le pagine dalla cache, attraverso un servizio chiamato iWebLab Cache Pro. Il problema viene raccontato come enorme; la soluzione commerciale, invece, viene presentata senza spiegare le condizioni che la rendono efficace.
Questa semplicità mi irrita perché tratta la complessità come qualcosa da nascondere quando arriva il momento di vendere. Chi legge potrebbe convincersi che basti attivare la cache per neutralizzare il problema appena descritto. Ma una possibilità tecnica non diventa una soluzione dimostrata perché le si appiccica un nome rassicurante. Servono condizioni, misure e risultati. Senza questi elementi rimane una promessa, una pubblicità ingannevole ed il conto dell’eventuale fallimento lo paga il negozio.
Sono stufo di vedere problemi complessi confezionati come occasioni per vendere un’etichetta rassicurante, per la reclame, la pubblicità. Chi lavora davvero su questi sistemi sa quante condizioni si nascondono dietro una risposta veloce. Chi compra hosting, spesso, quelle condizioni non le conosce. Questa differenza di competenze dovrebbe imporre ancora più chiarezza a chi vende. Quando viene sfruttata per lasciare intendere che una funzione risolva automaticamente qualsiasi carico, la comunicazione diventa, a mio giudizio, una presa in giro dell’intelligenza del cliente. E gli addetti ai lavori hanno il dovere di contestarla, chiedendo prove precise prima che una promessa troppo facile diventi un problema operativo pagato da qualcun altro.
La favola delle “due strade”: il cliente non deve finanziare il bot
Nel caso di un crawler che consuma risorse esplorando combinazioni di filtri prive di utilità dimostrata per il negozio, non ci sono due strade da presentare sullo stesso piano. C’è una priorità: proteggere l’attività del cliente. Mettere il blocco e un servizio di cache sullo stesso piano, come se fossero due risposte equivalenti, costruisce una falsa alternativa commerciale.
Due interventi tecnicamente possibili non sono automaticamente due strategie sensate. E non esauriscono nemmeno gli interventi disponibili: si può restringere l’accesso ai filtri, limitare il ritmo delle richieste, eliminare combinazioni inutili e lasciare accessibili le pagine che hanno un valore. Ma soprattutto, prima di preparare altre risposte per un crawler, bisogna decidere se quelle risposte meritino di essere prodotte.
Quando un bot sta martellando la navigazione faccettata, generando richieste nuove e costose senza un ritorno dimostrato, la prassi operativa sensata è bloccare o limitare quel comportamento e lasciare le risorse ai veri utenti. Prima si protegge il negozio, poi si valutano eventuali accessi utili. Il commerciante paga l’infrastruttura per vendere prodotti, permettere ricerche, aggiornare carrelli e concludere ordini. Non paga per mettere il proprio database a disposizione di chiunque decida di svuotargli il catalogo.
Presentare la capacità di continuare ad alimentare quel traffico come un pregio, senza mostrarne il beneficio, significa rovesciare le priorità. Il crawler ottiene i dati, il server sostiene il lavoro, il cliente paga le risorse e l’hosting presenta il proprio servizio. Il vantaggio per il commerciante, in questo racconto, dove sarebbe?
La cache può ridurre il costo delle richieste riutilizzabili. Non trasforma un’attività inutile in un’attività conveniente. Se il bot continua a chiedere combinazioni nuove, qualcun altro dovrà ancora produrre quei risultati. Aggiungere una cache non cancella questa responsabilità e non giustifica automaticamente il mantenimento dell’accesso.
L’hosting dovrebbe difendere il budget di risorse del cliente. Il cliente non deve finanziare un crawler solo per dare al fornitore l’occasione di raccontare quanto è bravo a servirlo. Il nome “Pro” non rende professionale una scelta che non ha ancora dimostrato alcun beneficio per chi paga.
Addestrare l’AI di altri non è un vantaggio commerciale !
Un bot di addestramento raccoglie contenuti per contribuire allo sviluppo di un modello. Questa attività, da sola, non garantisce al negozio visite, citazioni, ordini o una migliore visibilità. Servire migliaia di combinazioni del catalogo a quel bot non diventa marketing perché nella descrizione compare la sigla “AI”. Senza un ritorno documentato, il costo è concreto e il beneficio commerciale rimane tutto da dimostrare.
È particolarmente difficile giustificare quel costo quando si tratta di crawler di aziende cinesi impegnate a raccogliere dati per i propri modelli, senza un canale di ritorno dimostrato verso il negozio italiano. Un esempio concreto è Bytespider: Cloudflare lo attribuisce a ByteDance, l’azienda cinese proprietaria di TikTok, e lo include nella categoria dei crawler per l’addestramento AI. Citare questa categoria è pertinente; attribuire a quel bot il caso dello screenshot sarebbe un’altra cosa, perché nell’annuncio il crawler non viene identificato.
Proprio questa omissione merita una risposta: chi era il bot, quale attività stava svolgendo e quale beneficio produceva per il cliente? Scrivere “un assistente AI” non basta. Il cliente non è obbligato a pagare elaborazioni sul proprio catalogo per contribuire gratuitamente al modello di un’altra azienda. Vale per una società cinese, americana o europea: il costo del suo addestramento non diventa un’esigenza del negozio.
Nemmeno i nomi Claude, Gemini e OpenAI sono un lasciapassare. Bisogna distinguere le funzioni. OpenAI distingue GPTBot, destinato alla raccolta di contenuti utilizzabili per l’addestramento, da OAI-SearchBot, destinato alla ricerca. Anthropic distingue ClaudeBot da Claude-SearchBot e dalle richieste degli utenti tramite Claude-User. Per Google, Google-Extended controlla l’utilizzo per l’addestramento e il grounding di Gemini, senza determinare l’inclusione o il posizionamento nella Ricerca Google.
Un accesso legato alla ricerca o alla richiesta di un utente può avere un valore da valutare. Il crawling per addestramento è una scelta diversa. E anche un bot di ricerca riconosciuto non ha bisogno di esplorare senza limiti ogni combinazione dei filtri. Si possono rendere disponibili prodotti e categorie utili, proteggendo le parti del catalogo che producono soltanto carico.
Se il ritorno non c’è o non viene dimostrato, si ferma il comportamento che consuma risorse. Non si racconta al commerciante che deve continuare a sostenerlo per essere moderno. Il suo negozio deve servire i clienti. Il resto deve giustificare il proprio costo.
La domanda decisiva: cosa succede quando la pagina non è in cache?
Io voglio sapere cosa succede alle richieste che arrivano quando quella pagina, in cache, ancora non esiste.
È lì che si misura la qualità della soluzione. È lì che lavorano il database, l’applicazione e il sistema di ricerca. È lì che un negozio può rallentare mentre il cliente vero cerca un prodotto e prova a comprarlo.
Una cache conserva un risultato già ottenuto per poterlo riutilizzare. Se cento richieste compatibili chiedono la stessa pagina mentre la copia rimane utilizzabile, il vantaggio può essere enorme. Se cento richieste chiedono cento pagine diverse, tutte assenti dalla cache, quelle cento risposte devono ancora essere prodotte. L’eventuale beneficio di altri livelli di cache va valutato separatamente.
Questa distinzione dovrebbe comparire accanto alla promessa, con la stessa evidenza. Perché un crawler che attraversa sistematicamente combinazioni diverse può produrre proprio quel secondo scenario. Cambia colore, taglia, materiale, categoria, ordinamento, pagina. Ogni richiesta può identificare un risultato nuovo. E ogni risultato nuovo può significare un’altra elaborazione sul backend, ovvero CPU, RAM, banda, e server lento o peggio ancora offline.
Quanto viene effettivamente riutilizzato prima della scadenza? Questa è la domanda.
Varianti prodotto e URL filtrate: contiamo le cose giuste
Consideriamo un esempio con mille modelli di magliette, dieci colori e sette taglie. Il prodotto è corretto: 1.000 × 10 × 7 = 70.000 varianti teoriche. Aggiungendo altri due filtri come ad esempio tre scolli e tre materiali, tutti disponibili e combinabili, si arriva a 630.000 varianti.
Su questo punto voglio essere preciso: le varianti dei prodotti non coincidono automaticamente con le URL della navigazione faccettata. Un filtro per colore e taglia può mostrare contemporaneamente decine di magliette. I mille modelli non diventano necessariamente un moltiplicatore delle pagine filtrate.
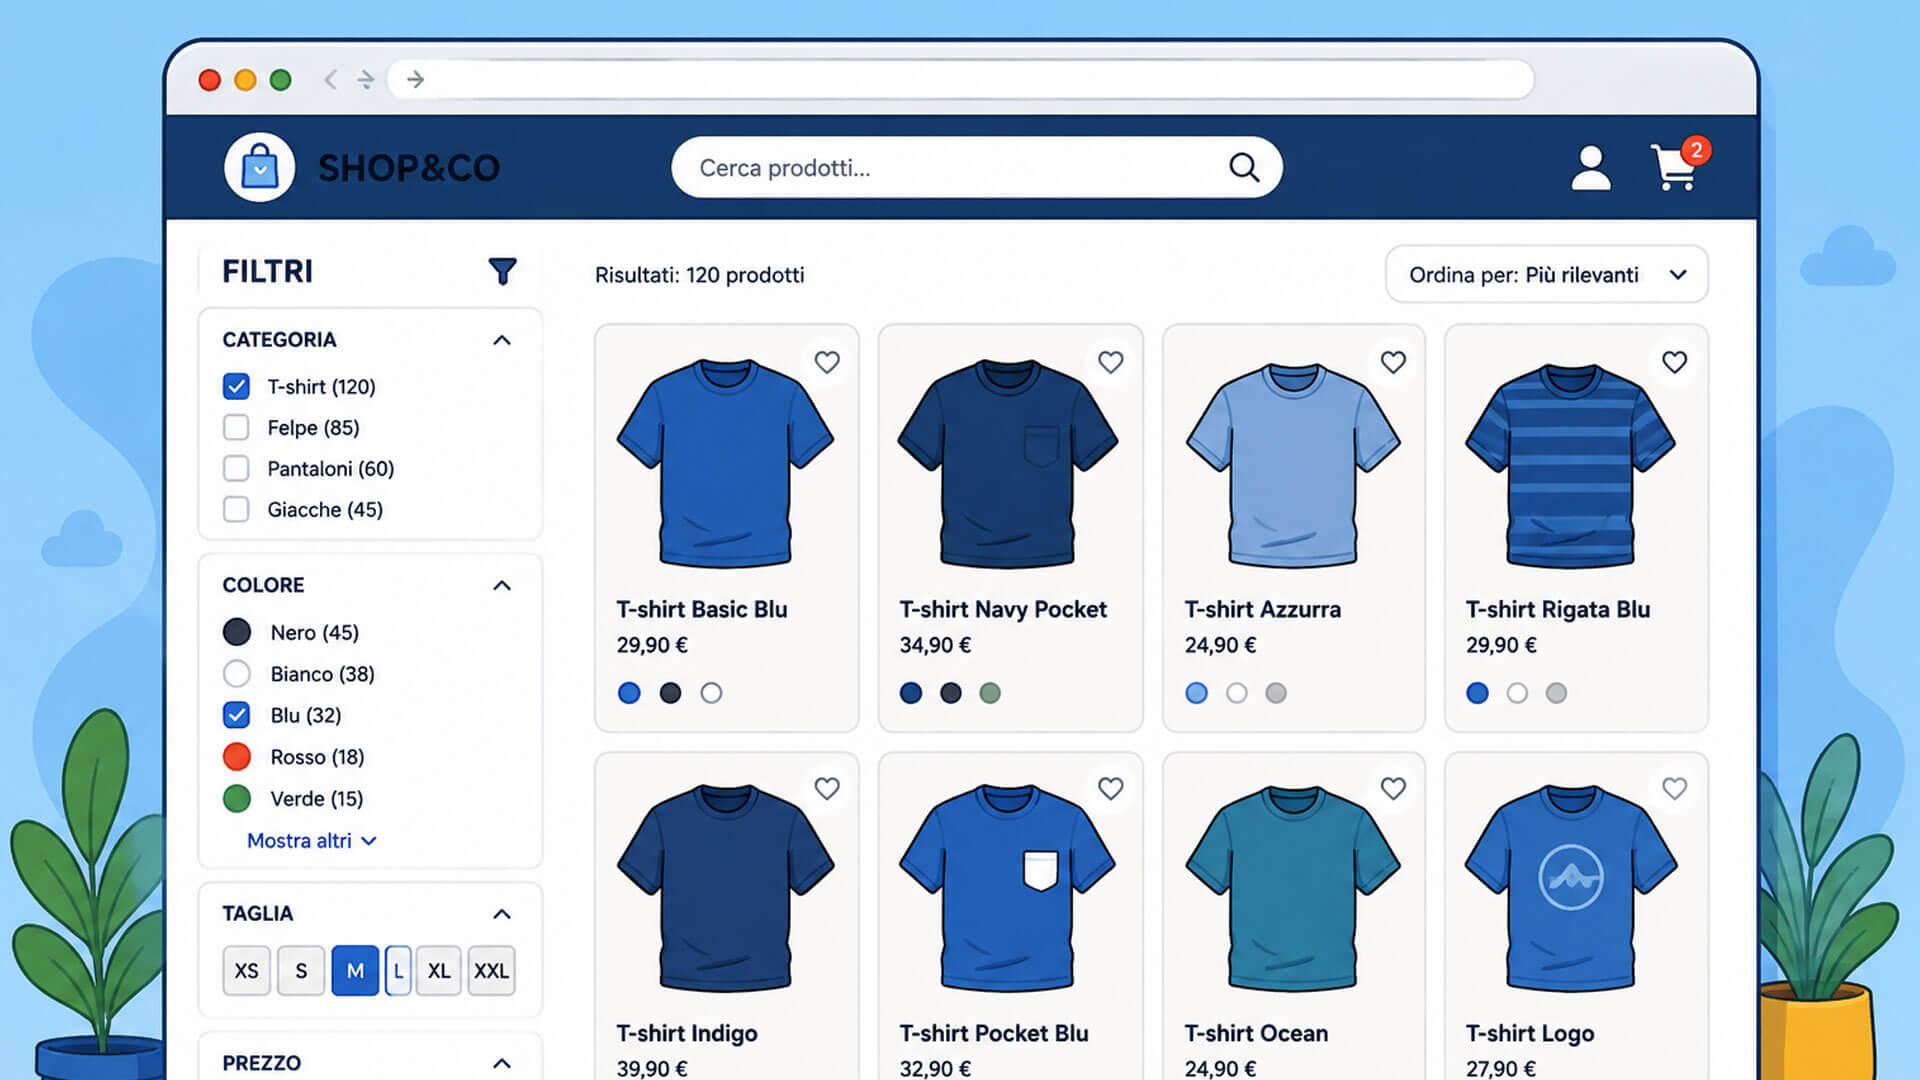
Con quattro filtri obbligatori, scegliendo un solo valore per ciascuno, dieci colori, sette taglie, tre scolli e tre materiali danno 630 combinazioni complete di filtri. Il conteggio cambia quando i filtri sono facoltativi, consentono selezioni multiple oppure si aggiungono categorie, paginazioni e ordinamenti. Le combinazioni prive di risultati non dovrebbero essere trattate come pagine utili.
Una critica tecnica deve distinguere questi numeri. Mi interessa una discussione che regga alla verifica, a partire dagli esempi utilizzati per spiegare il problema.
Il preriscaldamento ha un costo, anche prima dell’arrivo del bot
Se un catalogo espone davvero 70.000 URL distinte da preriscaldare, a dieci generazioni al secondo servono un’ora, cinquantasei minuti e quaranta secondi. Se ne espone 630.000, servono diciassette ore e trenta minuti. Sono conti aritmetici, basati su una velocità ipotetica, non benchmark del servizio mostrato nella schermata.
Dieci pagine al secondo possono essere poche oppure tante: dipende dal costo delle query, dall’applicazione, dagli indici, dalla piattaforma e dalle risorse disponibili. Ma chi propone questa strategia dovrebbe dichiarare quale velocità sostiene sul catalogo reale, insieme al carico che lascia a disposizione degli utenti.
Spostare un’elaborazione in una fase programmata può essere una scelta ottima. Consente di controllare il ritmo e utilizzare finestre favorevoli. Però quella scelta deve entrare nel dimensionamento del servizio. Il commerciante sta pagando risorse che dovranno sostenere anche la preparazione della cache, oltre alle visite e agli acquisti.
Prezzi e disponibilità cambiano: come si aggiorna la cache?
E poi il catalogo cambia. Cambiano prezzi, disponibilità, promozioni, prodotti e regole di visibilità. Alcuni aggiornamenti interessano poche pagine; altri possono coinvolgere molte combinazioni. L’invalidazione selettiva può aiutare enormemente, se è progettata bene. Proprio per questo pretendo che venga spiegata, invece di lasciarla nascosta dietro un generico “serviamo dalla cache”.
Per capire l’ordine di grandezza, mantenere integralmente aggiornate ogni ora 630.000 pagine richiederebbe una media di 175 generazioni al secondo. È un’ipotesi di rigenerazione completa, non una necessità universale. Ma rende evidente quanto siano importanti frequenza degli aggiornamenti e selettività dell’invalidazione.
Lo spazio su disco, invece, potrebbe essere relativamente modesto. Nell’ipotesi di dieci kilobyte per risposta, 630.000 risposte valgono circa 6,3 gigabyte di contenuto, prima degli overhead. Quel numero, da solo, non dimostra alcuna impossibilità tecnologica.
Il problema è produrre, aggiornare e riutilizzare le risposte entro il budget di risorse disponibile. Confondere la capacità di archiviare qualche gigabyte con la capacità di mantenere efficiente un catalogo sotto crawling aggressivo significa saltare la parte più importante della discussione.
HIT, MISS e tempi degli utenti: i numeri da mostrare
Quindi, prima di raccontare che abbiamo risolto il problema, mostriamo il tasso di HIT delle sole pagine faccettate richieste da quel crawler. Mostriamo i MISS al secondo, il costo delle query, il carico del database e i tempi di risposta degli utenti durante l’esplorazione.
Il dato aggregato dell’intero sito può nascondere proprio il problema che stiamo discutendo.
Voglio vedere cosa succede al primo passaggio del crawler, a cache vuota, e nei passaggi successivi. Voglio vedere cosa succede dopo una modifica del catalogo. Voglio sapere quante URL diverse vengono richieste e quante ricevono una seconda visita mentre la copia è ancora utilizzabile.
Questi sono dati verificabili. “Cache Pro” è un nome commerciale. Un nome commerciale non è una risposta tecnica e non sostituisce un benchmark.
Fermare il crawling inutile è proteggere il cliente
Google, nella documentazione sulla navigazione faccettata, raccomanda di impedire il crawling delle URL filtrate che non devono essere indicizzate. Quando invece devono essere esplorate, indica di gestire con attenzione la struttura delle URL e le combinazioni prive di risultati. Evidenzia anche che l’esplorazione di pagine inutili può rallentare la scoperta di contenuti utili.
Queste indicazioni riguardano Google. Un crawler AI può avere finalità e comportamenti diversi. Per ogni bot serve decidere che cosa rendere accessibile, a quale ritmo e con quale beneficio atteso. Una regola in robots.txt, inoltre, dipende dal rispetto del crawler; il controllo effettivo delle richieste può richiedere misure sul server o sul livello di protezione.
Il proprietario del negozio ha tutto il diritto di chiedere se quell’esplorazione sia utile alla propria attività. Ha anche il diritto di limitarla, senza sentirsi raccontare che la scelta più evoluta consista necessariamente nel comprare un servizio aggiuntivo per sostenerla.
Se il bot continua a generare richieste nuove, costose e prive di utilità, restringere l’accesso ai filtri o fermare quel comportamento può essere la decisione più sensata. Questo può lasciare disponibili pagine prodotto e categorie utili: il controllo può essere selettivo.
Una promessa non dimostrata non diventa vera perché vende bene
La mia posizione è precisa: servire dalla cache le pagine filtrate può essere efficace quando esiste un riutilizzo sufficiente e il costo di generazione e aggiornamento è sostenibile. Un insieme contenuto di combinazioni o un preriscaldamento selettivo possono aiutare; non esiste una soglia universale di prodotti o una durata magica di un’ora. Esistono anche strategie ibride. È proprio perché conosco queste possibilità che trovo inaccettabile presentarle senza spiegare le condizioni da cui dipende il risultato.
L’espressione “pagine praticamente infinite” non fornisce un conteggio. Non permette di conoscere quante URL distinte esistano né quanto tempo serva a generarle. Ma se viene utilizzata per dare forza a un caso commerciale, allora bisogna pubblicare proprio quei numeri. Con milioni di URL costose, il preriscaldamento potrebbe richiedere giorni o settimane; con altre condizioni potrebbe essere molto più rapido. Descrivere un problema come enorme e tacere i dati necessari a verificarne la soluzione è una scorciatoia commerciale che non accetto.
A mio giudizio, sul piano del messaggio commerciale, una comunicazione così si avvicina pericolosamente alla pubblicità ingannevole. Presenta una possibilità tecnica come risposta a un problema enorme, senza esporre i dati che consentono di capire se quella risposta regga. Non sto solo affermando che il servizio non funzioni, sto contestando anche una promessa che, nelle informazioni mostrate, non è dimostrata. Se il messaggio che si vuole far passare è che la cache renda innocua qualsiasi sequenza di combinazioni nuove, quel messaggio è tecnicamente falso. Una risposta assente dalla cache deve ancora essere prodotta: il nome del prodotto non modifica questo fatto.
Prima di acquistare, il cliente dovrebbe poter sapere quali risultati sono dimostrati, su quale catalogo, con quale frequenza di aggiornamento e a quale carico. Dovrebbe anche conoscere il comportamento del servizio quando il traffico supera quelle condizioni.
Chi vende hosting dovrebbe saper rispondere. Soprattutto quando usa un problema reale per promuovere un proprio prodotto.
In Managed Server abbiamo clienti che gestiscono anche cataloghi con 2 milioni di SKU.
Questa esperienza mi porta a chiedere numeri, distribuzione delle richieste e costi di elaborazione. Il numero dei prodotti, da solo, non basta; un catalogo piccolo può essere interrogato male e uno molto grande può essere progettato bene.
Trovo questo tono rassicurante una presa in giro dell’intelligenza del cliente. A chi non conosce HIT, MISS, invalidazione e costo delle query si offre una formula comoda, mentre tutte le condizioni scomode restano fuori dal racconto. Agli occhi di chi gestisce davvero questi sistemi, il nome altisonante conta zero se mancano le misure. Il presunto Santo Graal delle web performance deve superare una domanda banalissima: cosa succede quando il risultato non esiste ancora?
La complessità che scompare dal messaggio rimane sul server del cliente. Rimane nelle code, nelle query e nel tempo che una persona impiega a completare un acquisto.
Se avete costruito una soluzione efficace, dimostratelo nelle condizioni difficili che state citando. Pubblicate un caso riproducibile, con dati sufficienti a capire cosa protegge il backend e cosa continua a costargli lavoro.
Fino ad allora, l’espressione “pagine praticamente infinite” accostata alla promessa di servirle dalla cache merita domande molto scomode e conclusioni che possono solo sfociare in “Pubblicità ingannevole” ! Ogni risposta ha un costo di produzione, una durata utile e una probabilità di riutilizzo. Chi vende la soluzione deve rendere visibili questi tre elementi.
Il cliente paga per avere un negozio che funziona, non per finanziare il crawling altrui e fare da comparsa in una promessa commerciale.
Se avete una soluzione, mostrate i risultati. Se avete soltanto una formula rassicurante, smettete di presentarla come se bastasse a neutralizzare il problema. Le condizioni che omettete dalla pubblicità non scompaiono: restano sul server, e il conto rimane al cliente.
Marco Marcoaldi — CTO di Managed Server S.r.l.

