
Indice dei contenuti dell'articolo:
Novecentoquarantotto vulnerabilità del kernel Linux, ognuna con un exploit funzionante per diventare root, trovate da agenti di intelligenza artificiale in poche decine di ore. Il rapporto pubblicato da OpenAI, ripreso in Italia da Red Hot Cyber, segna un punto di non ritorno: la ricerca di falle non è più un lavoro artigianale. E se lo fa un grande laboratorio con regole e controlli, lo possono fare anche altri, con modelli a pesi aperti che chiunque può scaricare ed eseguire senza alcuna supervisione.
Per anni la sicurezza informatica ha vissuto di un equilibrio implicito. Trovare una vulnerabilità seria in un software maturo come il kernel Linux richiedeva competenze rare, settimane di lettura del codice, strumenti di fuzzing configurati con pazienza e una buona dose di intuito. Chi aveva queste capacità era poco numeroso, e questo limitava sia la quantità di falle scoperte sia la velocità con cui venivano sfruttate.
Quell’equilibrio si sta rompendo. Non per una singola scoperta clamorosa, ma per un cambio di scala: l’intelligenza artificiale sta trasformando la ricerca di vulnerabilità da attività di pochi specialisti a processo industriale, ripetibile e parallelizzabile. In questo articolo vediamo cosa è emerso dalla ricerca di OpenAI sul kernel Linux, perché i modelli a pesi aperti come GLM, DeepSeek, Kimi e Qwen cambiano il quadro, e cosa significa tutto questo per chi gestisce server e siti in produzione.
Cosa ha trovato l’IA nel kernel Linux
Secondo quanto riportato da Red Hot Cyber, che riprende un rapporto di OpenAI dal titolo eloquente “A thousand fewer paths to root”, un gruppo di agenti di intelligenza artificiale ha analizzato una porzione del kernel Linux alla ricerca di difetti sfruttabili. Il risultato finale è di 948 vulnerabilità uniche, ciascuna accompagnata da un exploit funzionante per l’elevazione locale dei privilegi fino a root.
Non si tratta di segnalazioni teoriche o di semplici crash: ogni falla è stata riprodotta e trasformata in un attacco che, partendo da un utente senza privilegi, ottiene il controllo completo del sistema. Durante il lavoro sono emerse anche almeno dieci tecniche di sfruttamento finora sconosciute, cioè modi nuovi di manipolare la memoria del kernel per arrivare ai privilegi più alti.
Il processo, descritto passo per passo, dà la misura di quanto sia diventato industriale:
- Selezione: 5.034 sezioni di codice, pari a circa 2,8 milioni di righe, il 7% circa dell’intero kernel.
- Analisi: in 12 ore gli agenti hanno individuato 2.308 potenziali problemi.
- Riproduzione: in 30 ore, dentro macchine virtuali con strumenti di rilevamento degli errori di memoria, ne sono stati confermati 1.724, il 74,7% delle segnalazioni iniziali.
- Sfruttamento: 291 dimostrazioni di fuga di informazioni e 1.169 exploit di elevazione dei privilegi, che tolti i duplicati diventano 948.
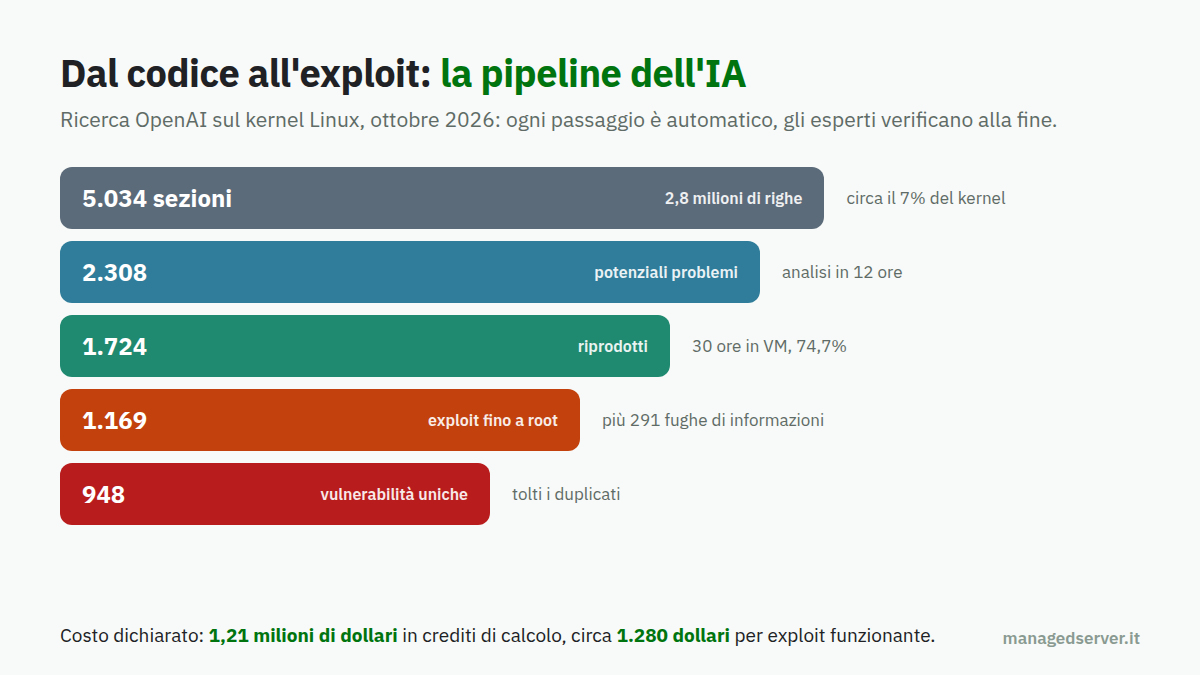
Il costo complessivo dichiarato è di circa 1,21 milioni di dollari in crediti di calcolo, cioè circa 1.280 dollari per ogni vulnerabilità con exploit funzionante. Per avere un termine di paragone, nelle competizioni come Pwn2Own un singolo exploit di questo tipo sul kernel Linux può valere decine di migliaia di dollari, e sul mercato grigio delle vulnerabilità i prezzi sono spesso più alti.
Cosa significa davvero, senza allarmismi
È importante leggere questi numeri con precisione, perché è facile trasformarli in titoli sensazionalistici. Lo stesso rapporto sottolinea alcuni punti che vanno tenuti presenti:
- Gli exploit richiedono un accesso locale al sistema: servono per passare da utente qualunque a root, non per entrare da remoto in un server che non espone nulla.
- Sono stati provati su configurazioni specifiche, in un ambiente isolato, su un Linux con le protezioni standard attive.
- Gli esperti umani hanno verificato cause, tecniche di sfruttamento e correzioni prima dell’invio ai maintainer. In una prima fase, 20 attacchi su 200 erano arrivati a root sfruttando una falla diversa da quella assegnata: un errore che ha portato a rendere più rigorosa la procedura.
- Le segnalazioni sono state inviate agli sviluppatori del kernel partendo dalle più gravi. Al termine della ricerca 61 falle erano già corrette nel ramo principale, 43 avevano una patch pronta e 299 erano in discussione pubblica.
Quindi no, non significa che qualsiasi server Linux possa essere violato dall’esterno domani mattina. Significa però qualcosa di più profondo e, a lungo termine, più preoccupante: l’elevazione dei privilegi, il secondo passo di quasi ogni attacco serio, è diventata abbondante ed economica. Chi entra in un sistema attraverso un plugin WordPress vulnerabile, una password debole o un servizio esposto per errore, si ritrova come utente limitato. Fino a ieri il salto a root era la parte difficile. Oggi lo è sempre meno.
Non è un caso isolato: l’accelerazione degli ultimi due anni
La ricerca di OpenAI è la più grande per dimensioni, ma si inserisce in una tendenza chiara. Già nel 2024 il progetto Big Sleep di Google aveva individuato con un modello linguistico una vulnerabilità sfruttabile in SQLite, uno dei software più diffusi al mondo. Nel 2025 un ricercatore ha usato il modello o3 di OpenAI per scoprire una falla di tipo use-after-free nel modulo ksmbd del kernel Linux, il server SMB integrato nel kernel, poi registrata come CVE-2025-37899. Nello stesso anno la competizione AIxCC promossa dalla DARPA ha messo alla prova sistemi completamente automatici capaci di trovare e correggere vulnerabilità in progetti open source reali.
La differenza tra quei casi e il rapporto di oggi è la scala. Si è passati dalla singola scoperta, celebrata come curiosità, a quasi mille falle sfruttabili in un unico ciclo di lavoro su una frazione del codice. E il kernel Linux è uno dei progetti più revisionati e scrutinati del pianeta. Viene spontaneo chiedersi cosa succede applicando lo stesso metodo a software meno curati: CMS, plugin, pannelli di controllo, firmware di router e dispositivi IoT, applicazioni scritte in fretta e mai più revisionate.
Il nodo dei modelli a pesi aperti
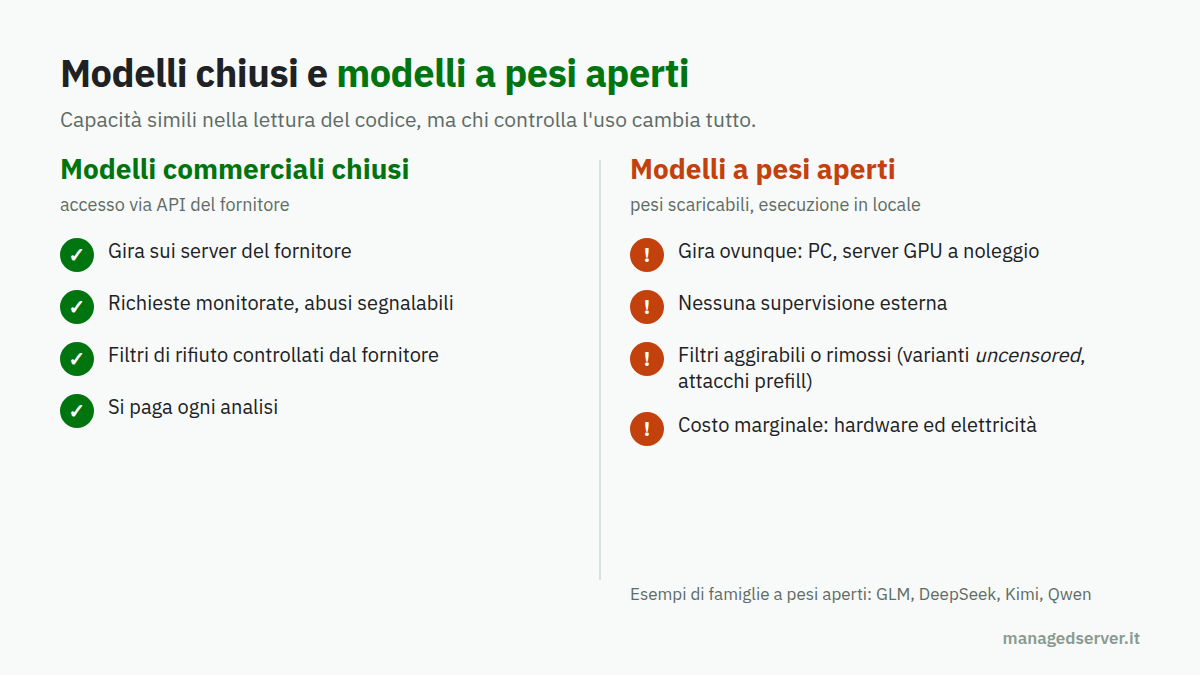
C’è un aspetto che nella discussione pubblica viene spesso sottovalutato. OpenAI ha condotto la sua ricerca con modelli propri, in un contesto controllato, con l’obiettivo dichiarato di correggere le falle e con una divulgazione responsabile verso i maintainer. I modelli dei grandi fornitori commerciali, inoltre, girano sui loro server: le richieste passano da sistemi di monitoraggio e da filtri pensati per rifiutare le attività chiaramente offensive.
I modelli a pesi aperti funzionano in modo diverso. Famiglie come GLM di Zhipu AI, DeepSeek, Kimi di Moonshot AI e Qwen di Alibaba vengono rilasciate con i pesi scaricabili: chiunque disponga di hardware adeguato o di un server GPU a noleggio può eseguirle in casa propria. Le loro capacità di ragionamento e di scrittura del codice, nelle versioni più recenti, si sono avvicinate molto a quelle dei modelli commerciali di punta. Questo ha enormi vantaggi per la ricerca, la riservatezza dei dati e l’indipendenza tecnologica, ma porta con sé tre conseguenze per la sicurezza:
- Nessuna supervisione: un modello eseguito in locale non comunica con nessuno. Non esiste un fornitore che possa vedere, segnalare o bloccare un uso malevolo.
- Filtri rimovibili: le protezioni che portano un modello a rifiutare certe richieste fanno parte dei pesi, e chi controlla i pesi può modificarle. Su Internet circolano da tempo varianti dichiaratamente uncensored dei modelli aperti più noti, ottenute con un nuovo addestramento mirato o con tecniche che neutralizzano il meccanismo di rifiuto. Uno studio pubblicato nel febbraio 2026 da Struppek, Gleave e Pelrine (arXiv:2602.14689) ha mostrato che anche senza modificare il modello, gli attacchi di tipo prefill, in cui si scrive l’inizio della risposta al posto del modello, risultano efficaci contro tutti i principali modelli a pesi aperti contemporanei.
- Costi in caduta: senza crediti API da pagare, il costo marginale di ogni analisi diventa quello dell’elettricità e dell’hardware. Un attaccante può lasciare girare decine di agenti in parallelo per settimane, su qualunque software gli interessi.
Non serve immaginare scenari fantascientifici. Gli strumenti per orchestrare agenti che leggono il codice, formulano ipotesi, compilano, eseguono test e riprovano sono in gran parte open source. Il pezzo che mancava era un modello abbastanza capace da tenere insieme il ragionamento, e quel pezzo oggi è scaricabile gratuitamente.
Quanti zero day ci sono in giro?
Nessuno può rispondere con un numero, ed è proprio questo il problema. Una vulnerabilità zero day è, per definizione, una falla che chi sviluppa il software non conosce ancora e per cui non esiste una correzione. Chi la trova può decidere di segnalarla, come ha fatto OpenAI, oppure di tenerla per sé, usarla o venderla.
Proviamo però a ragionare con i numeri pubblici. Un singolo laboratorio, analizzando circa il 7% del kernel Linux in poche decine di ore, ha trovato quasi mille falle sfruttabili che fino a quel momento nessuno aveva segnalato. Il kernel è codice scritto e rivisto con estrema cura da migliaia di sviluppatori esperti. È ragionevole pensare che nel restante 93% del kernel, e soprattutto nel mare di software meno sorvegliato che gira sui server di tutto il mondo, ce ne siano molte altre. Ed è altrettanto ragionevole pensare che non tutti quelli che hanno accesso a questi strumenti abbiano intenzione di segnalare ciò che trovano.
C’è poi un’asimmetria temporale che rende il quadro ancora più delicato. Trovare una falla oggi può richiedere ore; correggerla, farla accettare dai maintainer, distribuirla nelle versioni delle varie distribuzioni e infine installarla su ogni server richiede settimane o mesi. Nel rapporto di OpenAI, alla fine della ricerca, le falle già corrette nel ramo principale erano 61 su 948. Il resto era ancora in lavorazione. Moltiplicate questa finestra per tutti i software installati su un server tipico e diventa chiaro perché la velocità di aggiornamento sia diventata una questione di sicurezza, non di manutenzione.
Perché oggi la sicurezza conta più che mai
La conclusione non è che bisogna avere paura dell’intelligenza artificiale. Gli stessi strumenti che aiutano un attaccante aiutano chi difende: OpenAI ha trovato quelle falle per farle correggere, e sempre più progetti open source useranno agenti automatici per rivedere il proprio codice prima di rilasciarlo. Nel medio periodo il software diventerà probabilmente più solido.
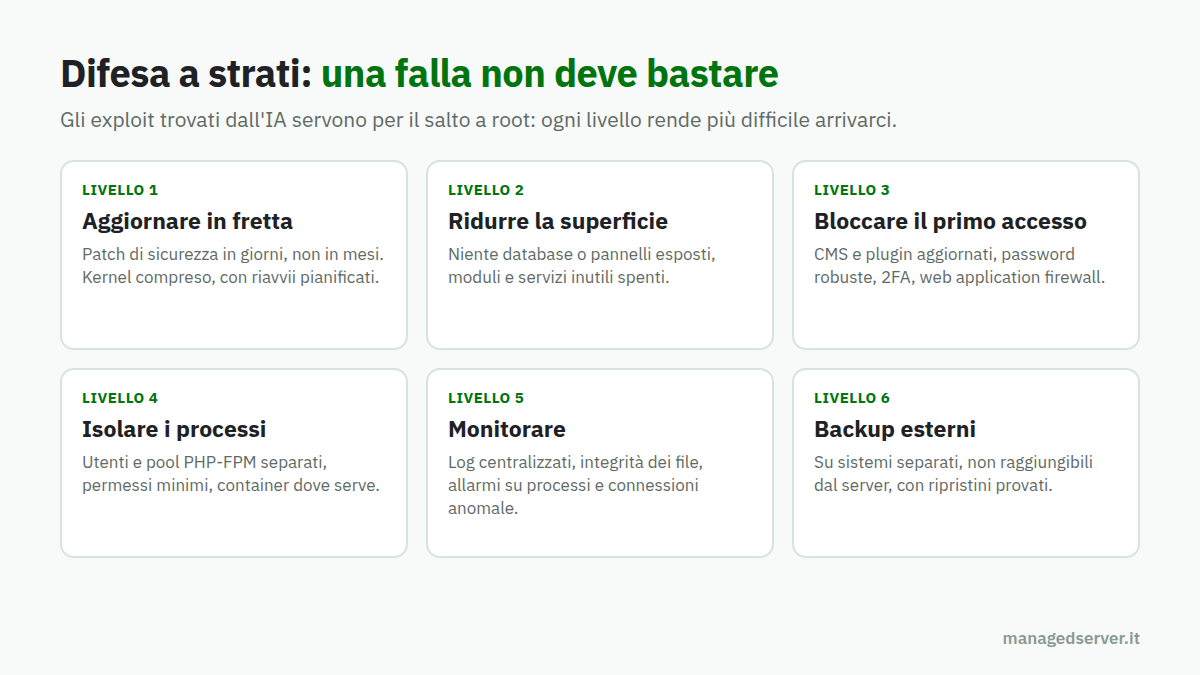
Nel frattempo, però, viviamo in una fase di transizione in cui le capacità offensive crescono più in fretta della capacità del mondo di applicare le correzioni. In questa fase la sicurezza non può più essere un’attività saltuaria, fatta una volta all’installazione del server e poi dimenticata. Deve diventare un processo continuo, costruito su più livelli, in modo che una singola falla non basti a compromettere tutto.
In concreto, per chi gestisce server Linux, siti web ed e-commerce, questo significa:
- Aggiornare in fretta, kernel compreso: le patch di sicurezza vanno applicate in giorni, non in mesi. Per il kernel servono un riavvio pianificato o, dove possibile, sistemi di aggiornamento a caldo.
- Ridurre la superficie di attacco: disattivare i moduli del kernel e i servizi che non servono, non esporre su Internet database, pannelli di amministrazione e porte di gestione, chiudere tutto ciò che non ha motivo di essere raggiungibile.
- Impedire il primo accesso: siccome gli exploit visti richiedono un accesso locale, il primo anello della catena è quasi sempre un’applicazione web vulnerabile, un plugin non aggiornato o una credenziale debole. CMS e plugin aggiornati, password robuste, autenticazione a due fattori e un web application firewall restano la prima linea di difesa.
- Isolare i processi: utenti separati per ogni sito, permessi minimi, PHP-FPM con pool distinti, container e sandbox dove ha senso. Se un’applicazione viene compromessa, il danno deve restare confinato.
- Monitorare e rilevare: log centralizzati, controllo dell’integrità dei file, allarmi su processi e connessioni anomale. Prima ci si accorge di un’intrusione, minore è il danno.
- Avere backup esterni e verificati: quando tutto il resto fallisce, un backup su un sistema separato, non raggiungibile da un server compromesso e provato con ripristini reali, è ciò che permette di ripartire.
Il ruolo di un sistemista nell’era degli exploit automatici
Tutto questo richiede tempo, competenza e soprattutto costanza: seguire gli avvisi di sicurezza, valutare quali riguardano davvero la propria infrastruttura, pianificare aggiornamenti e riavvii senza fermare il business, controllare che i backup funzionino. È un lavoro che difficilmente un’azienda riesce a portare avanti con continuità se la gestione dei server è un’attività accessoria.
È esattamente il tipo di lavoro che svolgiamo ogni giorno per i nostri clienti. Con i nostri Server Dedicati gestiti e i servizi di assistenza Linux ci occupiamo di aggiornamenti di sicurezza, hardening del sistema, isolamento dei siti, monitoraggio e backup e disaster recovery su infrastrutture separate. E quando qualcosa va storto, interveniamo anche nella rimozione di malware e nel ripristino dei siti compromessi.
Conclusioni
I 948 exploit trovati nel kernel Linux non sono una catastrofe annunciata, ma un segnale inequivocabile. L’intelligenza artificiale ha reso la scoperta di vulnerabilità veloce, economica e scalabile, e i modelli a pesi aperti come GLM, DeepSeek, Kimi e Qwen hanno messo capacità simili nelle mani di chiunque, senza supervisione e con filtri che possono essere aggirati o rimossi. Nessuno sa quante falle sconosciute siano già state trovate e restino nel silenzio, in attesa di essere usate.
Davanti a questo scenario la risposta non è il panico, ma il metodo: aggiornamenti rapidi, superficie di attacco ridotta, isolamento, monitoraggio e backup affidabili. Oggi come non mai, la sicurezza non è un costo da comprimere, ma la condizione per poter continuare a lavorare. Se vuoi capire quanto è esposta la tua infrastruttura e come proteggerla, contattaci: ne parliamo volentieri.

