
Indice dei contenuti dell'articolo:
Per anni il nostro sito ha convissuto con un paradosso che conosce bene chiunque faccia il nostro mestiere: passiamo le giornate a ottimizzare le infrastrutture dei clienti, e il sito che racconta quel lavoro finisce sempre in fondo alla lista delle priorità. Il tempo che avremmo dovuto dedicare a managedserver.it lo dedicavamo, giustamente, a chi ci paga per farlo.
La soluzione di comodo è stata, per molto tempo, un servizio esterno di ottimizzazione: Nitropack. Un abbonamento annuale, un plugin, una configurazione di mezz’ora, e i test di PageSpeed Insights su mobile tornavano sopra i 90 punti. Comodo, veloce, e con un numero verde da mostrare.
Poi abbiamo cominciato a guardare come quel numero veniva ottenuto, e ci è passata la voglia.
Perché abbiamo smesso di fidarci del punteggio
Analizzando il comportamento della pagina servita con Nitropack ci siamo resi conto che, nel nostro caso, alcune delle tecniche adottate producevano un risultato che percepivamo molto più vicino a un’ottimizzazione del test che a una vera ottimizzazione dell’esperienza dell’utente.
In particolare abbiamo osservato diversi aspetti che non ci convincevano:
- JavaScript rimandato fuori dalla finestra di misurazione. Gli script non venivano necessariamente resi più leggeri o più rapidi: una parte del lavoro veniva eseguita dopo la prima interazione dell’utente oppure con un ritardo sufficiente a spostarlo oltre la fase più rilevante della misurazione. Il Total Blocking Time risultava così molto basso, ma parte del carico veniva semplicemente sostenuta più tardi dal browser.
- Comportamenti differenti durante le misurazioni. Analizzando le risposte e il comportamento complessivo della pagina abbiamo ritenuto che il risultato del test non rappresentasse in maniera sufficientemente fedele quello che volevamo offrire a un normale visitatore.
- Una catena di problemi collaterali. Consenso cookie che partiva in ritardo, widget che comparivano a scatti, immagini sostituite in modo poco prevedibile e una dipendenza importante da una CDN e da un servizio di terzi per servire il nostro stesso sito.
- Nessun beneficio proporzionato sulle reti lente. Il punto più importante: su una connessione 4G scarsa, quella che usano realmente molte persone che leggono un sito dal telefono, la pagina non risultava necessariamente più veloce nello stesso modo in cui il punteggio sintetico poteva far pensare.
Il punteggio, insomma, aveva smesso di essere per noi un indicatore sufficiente. Era diventato un numero che volevamo capire meglio, non semplicemente inseguire.
Così, con una settimana di anticipo sulla scadenza del rinnovo annuale, abbiamo deciso di fare la cosa che consigliamo ai clienti da sempre: sederci, misurare e ottimizzare a mano. Con l’obiettivo dichiarato di disdire l’abbonamento senza perdere prestazioni e, possibilmente, migliorandole davvero.
Questo articolo racconta cosa abbiamo fatto, nell’ordine in cui lo abbiamo fatto, con i numeri reali che abbiamo misurato.
Il punto di partenza
Lo stack del sito è quello che consigliamo ai clienti WordPress che vogliono prestazioni: nginx in front con TLS, HTTP/2 e HTTP/3, Varnish come cache di pagina, un nginx interno come backend, PHP-FPM con pool dedicato e MariaDB. Il tema è Astra, il builder è Elementor, con Autoptimize per aggregare CSS e JavaScript.
Disattivato Nitropack, la home mobile su PageSpeed Insights oscillava fra 76 e 86 punti, con un Largest Contentful Paint fra 3,8 e 5,3 secondi a seconda del giro. Il desktop stava fra 97 e 100.
I dati di campo, quelli del Chrome User Experience Report, erano già verdi: LCP 0,7 secondi, INP 73 millisecondi, CLS 0. Gli utenti reali stavano bene. Era il laboratorio a non essere allineato, e il laboratorio è anche quello che molti utenti, tecnici e potenziali clienti guardano quando vogliono capire quanto sia veloce un sito ma soprattutto che diventa importante quando ci si trova di fronte a connessioni mobile lente.
C’è una paradosso e un bias cognitivo tra gli addetti ai lavori che si pre-occupano di fare ottimizzazione delle Web Performance, che è quello di dare peso in modo esclusivo solo ai dati sul campo, i dati CRUX “Chrome Real User Experience” e fregarsene totalmente dei dati di laboratorio, dati LABS. Per capirne bene la differenza vi consigliamo questo articolo : Core Web Vitals e dati CRUX.
Tuttavia i dati CRUX sono solo la media della navigazione degli utenti e delle loro connessioni, pertanto se ci troviamo di fronte ad un sito Internet che viene visualizzato per il 90% da utenti di Milano e Roma che hanno connessioni veloci, fibra e 5G dappertutto avremo dei valori CRUX ottimali anche a fronte di un sito realmente lento che se navigato da qualche paesello montuoso in Sardegna con una connessioni 4G lenta, non supererebbe minimamente i dati CRUX.
La forma mentis importante dunque è quella di dare certamente valore e importanza ai dati CRUX ma allo stesso tempo tenere sempre d’occhio di dati LABS.
Un dettaglio importante prima di elencare gli interventi: nessuno degli interventi che abbiamo introdotto cambia intenzionalmente l’HTML per ottenere un risultato migliore esclusivamente nei confronti del tester. Il nostro obiettivo era fare in modo che ciò che misura Lighthouse fosse il più possibile rappresentativo della pagina che utilizza realmente un visitatore.
Come abbiamo misurato
Una parte consistente del lavoro è stata dedicata alla misura, perché senza un metodo affidabile si finisce facilmente per ottimizzare il rumore.
Lighthouse locale, non solo PageSpeed Insights
PageSpeed Insights presenta alcuni limiti pratici quando si devono eseguire decine di test consecutivi. Per questo ci siamo dotati anche di Lighthouse in locale, utilizzando Chrome di sistema, in modalità Headless su Linux Ubuntu in WSL su Windows, in modo da poter eseguire serie di misurazioni e analizzare direttamente i trace.
Osservato contro simulato
Lighthouse su mobile applica una simulazione delle condizioni di rete e CPU sopra una registrazione. Il valore simulato dell’LCP, quello che contribuisce al punteggio, dipende in maniera importante anche da variabili che possono essere meno evidenti osservando soltanto il risultato finale.
Tra queste abbiamo identificato soprattutto la dimensione complessiva del documento e il lavoro della CPU che precede il rendering dell’elemento LCP.
La bimodalità delle misurazioni
Abbiamo scoperto inoltre che una parte dei test cadeva in una sorta di “modalità lenta”: il primo frame veniva presentato oltre il secondo, mentre il thread principale risultava aver già eseguito il painting della pagina molto prima.
Questo ci ha insegnato una cosa importante: un singolo giro di Lighthouse dice molto poco. Per gli interventi più delicati abbiamo quindi lavorato su serie di più test, osservando la distribuzione dei risultati anziché fidarci del numero migliore o peggiore.
Il JSON grezzo di PageSpeed Insights
Per confrontare realmente le nostre misure con quelle di Google abbiamo analizzato anche il risultato completo prodotto da Lighthouse tramite PageSpeed Insights, osservando la scomposizione dell’LCP in TTFB, ritardo di caricamento, durata del caricamento e ritardo di rendering.
Questa scomposizione è stata la bussola di buona parte del lavoro successivo.
Gli interventi, uno per uno
1. Un critical CSS per pagina e per dispositivo
Il primo intervento strutturale ha riguardato il CSS.
Il CSS aggregato del sito pesa centinaia di KB e un foglio di stile bloccante di quella dimensione è uno dei principali nemici del First Contentful Paint. La soluzione classica consiste nell’inserire il critical CSS inline e caricare successivamente il foglio completo.
Su un sito costruito con Elementor, però, c’è una complicazione: ogni pagina ha regole riferite ai singoli elementi, con identificativi specifici. Di conseguenza un critical CSS generico condiviso tra tutte le pagine non è sufficiente. Ne serve uno per pagina e, nel nostro caso, anche uno differenziato per dispositivo, perché la testata mobile di Astra e quella desktop si comportano in maniera diversa.
Abbiamo costruito una procedura ripetibile che oggi ci permette di completare l’operazione in circa dieci minuti per pagina:
- generazione tramite Penthouse con viewport alto, 2200 pixel, per non perdere le regole relative alle sezioni appena sotto la piega;
- JavaScript attivo durante la generazione, perché Astra applica via script alcune classi necessarie alla testata mobile;
- potatura in base alla copertura reale, misurando con Chrome quali regole vengono effettivamente utilizzate;
- reintroduzione delle regole di impaginazione necessarie a Swiper, per evitare che i caroselli si impilino verticalmente prima dell’arrivo del CSS completo;
- verifica visuale sopra la piega su più viewport;
- misura del CLS dopo il deploy sia su mobile sia su desktop.
Il risultato è stato un passaggio da circa 130 KB di critical CSS candidato a 55-60 KB effettivamente necessari.
Oggi 47 pagine del sito hanno il loro critical CSS mobile e desktop, con il foglio completo differito e senza richieste CSS bloccanti non necessarie.
Il critical CSS ha inoltre fatto emergere alcuni difetti che prima erano semplicemente nascosti dal caricamento bloccante del foglio completo. Per esempio immagini hero prive dello spazio preventivamente riservato: quando il primo rendering avveniva più tardi, il problema non era evidente; anticipando il rendering, invece, diventava visibile sotto forma di layout shift che andava a pesava oltre che sulla resa visiva inguardabile dal punto di vista estetico anche sulla metrica CLS Cumulative Layout Shift.
Tre varianti dello stesso problema sono state corrette con tre semplici regole CSS.
2. content-visibility per non impaginare quello che non si vede
Una home Elementor composta da 34 sezioni e circa 3.300 elementi richiede al browser un lavoro significativo di style calculation e layout, anche quando una grande parte di quegli elementi si trova migliaia di pixel sotto la finestra visibile.
Con content-visibility: auto e un contain-intrinsic-size misurato sezione per sezione abbiamo permesso al browser di saltare il rendering di ciò che non è ancora vicino al viewport.
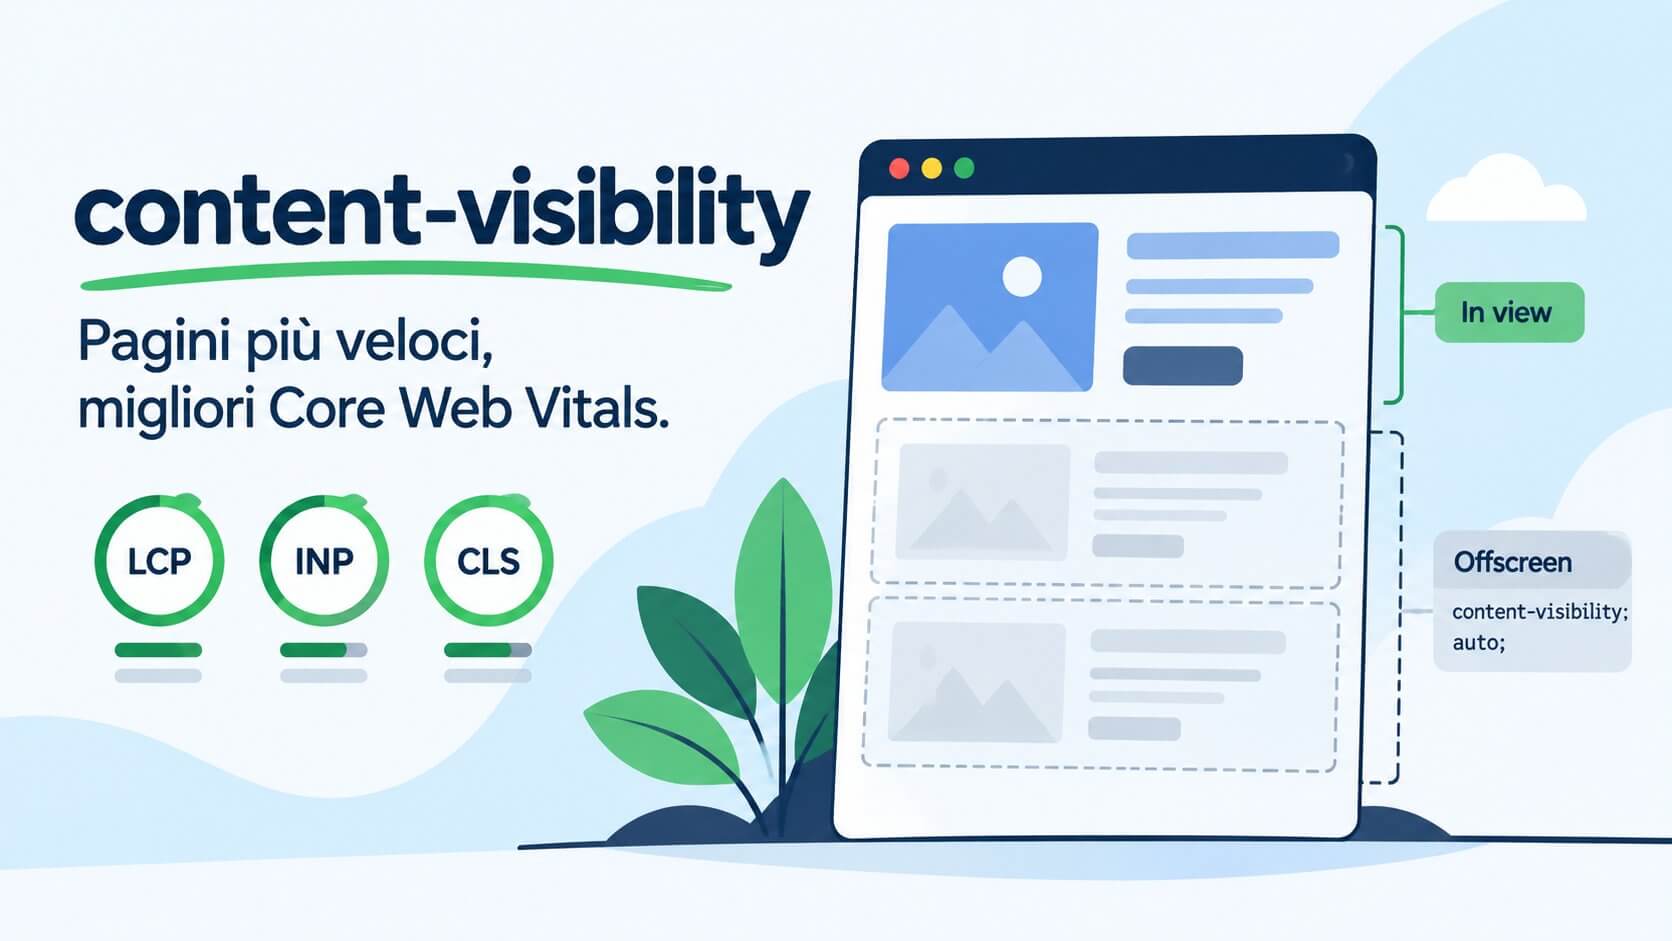
Le altezze sono state misurate realmente, per ogni pagina e per ogni dispositivo, dopo aver percorso interamente il documento, perché le immagini caricate in lazy loading possono modificare l’altezza finale delle sezioni.
Su mobile la regola interviene dalla prima sezione che supera circa 1400 pixel cumulati. Su desktop dalla quinta. Il footer, che sul mobile arriva a circa 4.400 pixel di altezza, viene escluso dal rendering iniziale praticamente ovunque.
C’è stato anche un beneficio secondario interessante: un font utilizzato esclusivamente all’interno delle sezioni non renderizzate può non essere scaricato fino a quando non diventa realmente necessario.
3. Capire chi forza il layout
Strumentando le API geometriche del browser, tra cui getBoundingClientRect(), abbiamo scoperto che alcuni gestori di Elementor forzavano il layout delle sezioni escluse dal rendering iniziale già poche centinaia di millisecondi dopo il caricamento.
Tra questi c’erano lo stretch section, che misura posizione e larghezza delle sezioni, e le nested tabs.
Il risultato era che un font di circa 20 KB, necessario esclusivamente molto sotto la piega, poteva essere richiesto dopo appena 640 millisecondi.
Sulla home abbiamo quindi sostituito buona parte dello stretch JavaScript con CSS. Delle 18 sezioni che lo utilizzavano, misurate su viewport compresi fra 1280 e 2560 pixel, 15 erano già naturalmente larghe quanto la finestra.
Le altre tre appartenevano a un template con contenitore da 1400 pixel e hanno potuto essere estese con una semplice regola basata su width: 100vw e margin-left: calc(50% - 50vw), senza necessità di calcoli JavaScript.
4. Il documento dimezzato: gli SVG inline
Questa è stata probabilmente la leva più importante dell’intero lavoro, e difficilmente l’avremmo individuata senza analizzare il documento HTML praticamente byte per byte.
La home mobile pesava circa 647 KB non compressi e 128 KB compressi. Di questi, circa 71 KB compressi erano costituiti da SVG inline: 45 icone dei widget Elementor inserite direttamente per esteso nel documento.
Una singola icona, derivata da un logo vettorializzato con 83 tracciati, pesava circa 100 KB non compressi e 30 KB compressi. In pratica quasi un quarto dell’intero documento HTML compresso per un’icona nascosta all’interno di una scheda chiusa.
Nel modello di Lighthouse, ridurre la dimensione del documento può avere un effetto importante anche sulle metriche di rendering. La verifica in laboratorio, riscrivendo il documento, mostrava un passaggio da circa 91 a 97-98 punti e un miglioramento nell’ordine di 0,7 secondi su FCP e LCP.
L’implementazione definitiva utilizza un filtro sul buffer di output del tema:
- gli SVG successivi alla seconda sezione di primo livello rimangono nel documento come elementi
<svg>vuoti con gli stessi attributi, mantenendo quindi box e dimensioni; - i disegni vengono spostati in un file specifico per la pagina, comprimibile e servibile con cache lunga;
- uno script in fondo al body, quando l’icona si avvicina alla finestra, scarica il file una sola volta;
- i simboli vengono copiati in un SVG nascosto nel documento e le singole icone vengono ricostruite tramite
<use>locale.
Nel farlo abbiamo incontrato anche tre problemi che fanno capire la differenza tra un’idea teoricamente corretta e un’implementazione realmente utilizzabile.
Il primo riguarda i riferimenti a file SVG esterni: in determinate condizioni Chrome può lasciare temporaneamente vuote le icone inserite mentre il file è ancora in caricamento. Da qui la decisione di copiare i simboli nel documento.
Il secondo riguarda la collisione degli identificativi e delle classi. Se due loghi utilizzano entrambi una classe come .st0, uno stile può sovrascrivere quello dell’altro. Abbiamo quindi introdotto un prefisso specifico per simbolo.
Il terzo riguarda la severità del parser XML: un attributo con namespace non dichiarato può rendere invalida una parte del file. Gli SVG vengono quindi normalizzati e validati prima di essere estratti dall’HTML.
L’icona da 100 KB è stata inoltre sostituita con il vettoriale ufficiale da appena 457 byte.
Il risultato complessivo è che la home mobile è passata da 128 KB a circa 62 KB di HTML compresso.
5. Font: solo quello che serve, quando serve
Anche sui font abbiamo scelto di intervenire solo dove le misure mostravano un beneficio reale.
- Abbiamo rimosso dai critical CSS le 14 facce latin-ext di Open Sans che il sito non utilizza.
- L’icona Linux nella hero, che da sola obbligava il browser a scaricare circa 10 KB di Font Awesome Brands prima dell’LCP, è diventata un SVG inline estratto dal font.
- I sottoinsiemi dei font del marchio erano già sufficientemente ottimizzati: circa 189 glifi latini per 22 KB. Li abbiamo verificati e lasciati invariati.
- I preload sono stati riesaminati uno per uno, mantenendo esclusivamente quelli che producevano un vantaggio misurabile.
Un caso è particolarmente significativo. Il preload di un font utilizzato soltanto sotto la piega, aggiunto inizialmente per eliminare una dipendenza segnalata da PSI, peggiorava l’LCP di circa 170 millisecondi in laboratorio.
È stato quindi eliminato. Avere un albero delle dipendenze apparentemente più pulito non significa necessariamente avere una pagina più veloce.
6. JavaScript: differire quello che si deve, eliminare quello che si può
Non abbiamo replicato un modello basato sul ritardare indiscriminatamente tutto il JavaScript fino alla prima interazione dell’utente. Quel tipo di soluzione può certamente migliorare alcune metriche sintetiche, ma rischia anche di lasciare caroselli, tab, menu e altri componenti non completamente inizializzati per una parte dell’esperienza.
Abbiamo preferito intervenire in modo selettivo:
- jQuery differito, con uno shim minimo per la compatibilità con jQuery UI e un filtro per gli script inline dei plugin che chiamano jQuery sincronicamente;
- wp-i18n e wp-hooks rimossi dal frontend nei punti in cui non risultavano effettivamente utilizzati;
- iubenda ritardata attraverso una nostra logica di inizializzazione;
- tooltip caricati all’avvicinarsi del mouse;
- widget chat caricati successivamente;
- analytics inizializzati nel rispetto del consenso.
Il punto per noi importante è che la pagina reale rimanga utilizzabile e coerente, senza trasformare l’ottimizzazione in un semplice esercizio per ridurre ciò che Lighthouse riesce a osservare.
Il Total Blocking Time finale si colloca generalmente tra 3 e 50 millisecondi.
jQuery resta ancora presente. Elementor lo richiede e, con un TBT di questo livello, eliminarlo a tutti i costi non avrebbe prodotto un beneficio proporzionato. Rimuoverlo davvero significherebbe ripensare completamente la home senza Elementor: un progetto diverso,
7. Lo stack: microcache, compressione una volta sola e un bug vecchio di anni
Una parte importante del lavoro è stata svolta anche sotto WordPress, perché le prestazioni reali non finiscono con HTML, CSS e JavaScript.
Un microcache nginx davanti a Varnish
Abbiamo introdotto un microcache nginx davanti a Varnish, non tanto per migliorare ulteriormente la velocità dei cache HIT, sui quali Varnish rispondeva già nell’ordine del millisecondo, quanto per aumentare la resilienza dell’intero stack e assorbire meglio eventuali picchi o anomalie del livello sottostante.
In pratica nginx rappresenta un ulteriore strato molto leggero davanti a Varnish, capace di servire immediatamente una copia già disponibile senza dover coinvolgere nuovamente tutta la catena applicativa. Il vantaggio principale non è quindi spremere qualche millisecondo in meno da una risposta che era già veloce, ma ridurre il numero di richieste che devono realmente raggiungere Varnish, nginx backend, PHP-FPM e WordPress quando non è necessario.
La configurazione consente inoltre di aggiornare gli oggetti in background, continuando nel frattempo a servire la copia corrente, e di utilizzare una copia precedente in caso di errore temporaneo del backend. Questo significa che un rallentamento, un timeout o un breve problema applicativo non deve necessariamente tradursi in un errore percepito dall’utente: se esiste ancora una copia valida o utilizzabile in cache, nginx può continuare a servirla mentre il livello sottostante si riprende.
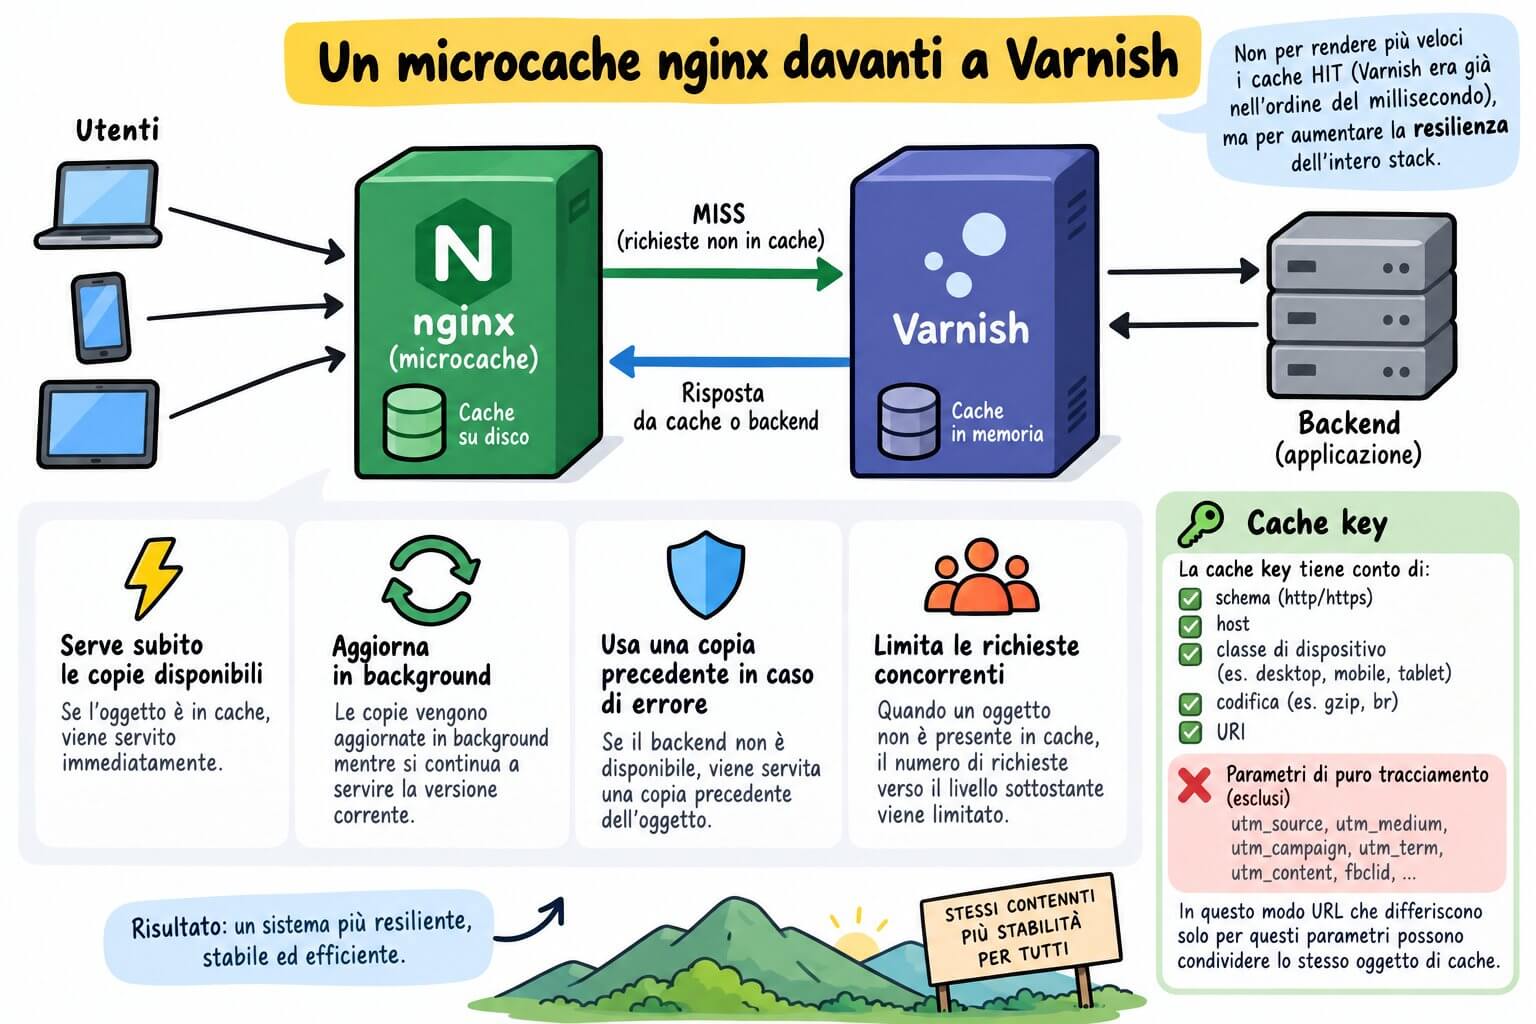
Un altro aspetto importante è il controllo delle richieste concorrenti in caso di cache MISS. Quando un oggetto non è presente in cache, invece di permettere a decine di richieste simultanee per lo stesso URL di attraversare tutte insieme lo stack, è possibile fare in modo che una sola richiesta aggiorni la copia mentre le altre attendono o utilizzano quella già disponibile. È un accorgimento particolarmente utile durante picchi di traffico o subito dopo uno svuotamento della cache, perché evita il classico effetto “thundering herd” sul backend.
Anche la cache key è stata costruita con attenzione. Tiene conto di schema, host, classe di dispositivo, codifica e URI, mentre i parametri utilizzati esclusivamente per il tracciamento vengono esclusi. In questo modo URL che differiscono soltanto per parametri come utm_source, utm_medium, utm_campaign o fbclid possono condividere lo stesso oggetto di cache.
È un dettaglio meno banale di quanto sembri: senza questa normalizzazione, la stessa pagina potrebbe finire in cache più volte soltanto perché raggiunta da campagne, social network o sorgenti differenti. Eliminare dalla chiave ciò che non modifica realmente il contenuto permette quindi di aumentare il tasso di HIT, ridurre lo spreco di memoria e limitare ulteriormente il lavoro richiesto al backend.
Il risultato è un livello di cache che non serve tanto a rendere “più veloce del veloce” una risposta già presente in Varnish, quanto a rendere l’intera architettura più stabile, prevedibile e resistente agli errori.
La compressione spostata nel backend
In precedenza il frontend ricomprimeva le risposte anche quando provenivano dalla cache, spendendo circa 30-40 millisecondi di CPU per HTML e CSS.
Abbiamo spostato la compressione nel backend, in modo che venga eseguita una volta sola per pagina e per codifica. Varnish e NGINX possono quindi conservare e servire direttamente le varianti già compresse, utilizzando correttamente Vary: Accept-Encoding.
Nel nostro caso abbiamo dovuto tenere conto di un comportamento specifico del parametro http_gzip_support, che può interferire con la gestione delle diverse codifiche verso il backend.
Livelli di compressione scelti sui numeri
Per l’HTML abbiamo scelto Brotli 9 e Zstandard 15. Salire ulteriormente aumenta sensibilmente il costo CPU a fronte di una riduzione dei byte che, nei nostri test, non giustificava il maggior tempo speso su una cache MISS.
Per i file prodotti da Autoptimize, che contengono l’hash del contenuto nel nome e possono quindi rimanere in cache a lungo, utilizziamo livelli più aggressivi: Brotli 11 e Zstandard 19.
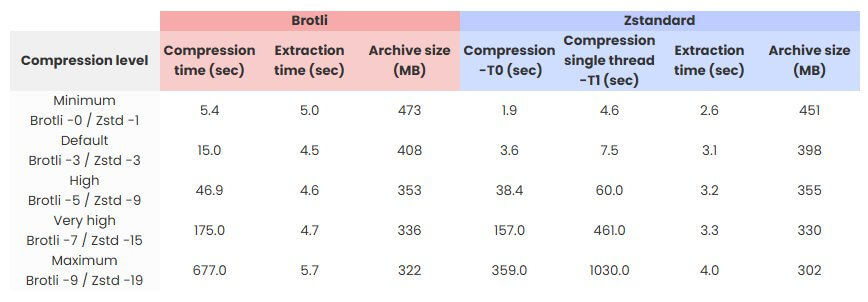
In questo secondo caso sostenere una maggiore spesa CPU una sola volta ha un rapporto costo-beneficio decisamente migliore.
Il bug che spiegava le richieste appese
Durante le procedure di warmup avevamo notato che circa l’1,5% delle richieste poteva rimanere senza risposta per periodi compresi tra 120 e 300 secondi, apparentemente su URL casuali.
PHP non compariva nei log delle slow request, quindi abbiamo continuato a scendere nello stack.
Nel ring buffer di Varnish abbiamo trovato migliaia di errori http first read error: -1 11.
La causa era nel riutilizzo di connessioni keepalive che il backend nginx aveva già chiuso dopo il periodo di inattività. Varnish tentava quindi di scrivere una nuova richiesta su un socket ormai morto, aspettava il first_byte_timeout e poteva successivamente attraversare più restart definiti dal VCL.
La correzione è stata semplice: keepalive_timeout 0 sul backend. Ogni fetch apre una nuova connessione su loopback, con un costo trascurabile nel nostro scenario, eliminando però la race condition.
Abbiamo poi verificato la soluzione riproducendo esattamente la finestra temporale che causava il problema: zero errori.
Le piccole cose che si scoprono solo guardando
Durante l’analisi abbiamo trovato anche problemi meno spettacolari, ma comunque degni di essere corretti:
- il MIME type dei file WOFF2 era
application/octet-stream; - alcuni file statici uscivano con due header
Cache-Control; - lo storage di Varnish era limitato a 512 MB, mentre il sito, considerando tre codifiche e due classi di dispositivo, poteva occupare circa 520 MB.
Lo storage di Varnish è stato quindi portato a 2 GB in RAM.
8. Il warmup con tre codifiche
Quando la cache conserva una copia distinta per codifica, un warmup che richiede ogni URL una sola volta scalda soltanto una delle possibili varianti.
Abbiamo quindi riscritto il nostro script partendo dalla sitemap:
- richieste GET e non HEAD;
- tre richieste per URL con gzip, Brotli e Zstandard;
- user-agent mobile e desktop;
- un processo controllato alla volta;
- pausa configurabile tra le richieste per non saturare inutilmente PHP-FPM su cache completamente vuota.
Il warmup completo del sito ha interessato 781 URL, due dispositivi e tre codifiche, per un totale di 4.386 richieste.
La procedura ha richiesto circa tre ore e un quarto, senza mai superare un load medio di 1. Su URL campione controllati successivamente abbiamo ottenuto 24 HIT su 24, con tempi compresi fra 22 e 48 millisecondi.
Quello che non abbiamo fatto, e perché
L’onestà sui limiti di un intervento è importante quanto l’elenco dei risultati ottenuti.
- Non abbiamo identificato definitivamente la causa della “modalità lenta” del primo frame in laboratorio. In una parte dei giri Lighthouse il main thread risulta aver dipinto la pagina molto prima del momento nel quale il compositor presenta effettivamente il frame. Abbiamo provato numerose varianti della home rimuovendo script, video,
content-visibility, fogli esterni, preload e gruppi di sezioni, senza riuscire a isolare un unico responsabile. Nei dati di campo il comportamento non è osservabile, quindi abbiamo documentato il fenomeno e deciso di non inseguirlo oltre. - Non abbiamo rigenerato un critical CSS limitato esclusivamente alla prima piega. Il passaggio da circa 57 a 35 KB non compressi produceva soltanto qualche decina di millisecondi di miglioramento in laboratorio, introducendo però il rischio di vedere la seconda sezione sistemarsi durante il caricamento.
- Non abbiamo ritagliato per pagina tutto il CSS differito. Sulla home una parte molto significativa del foglio completo non viene utilizzata, ma costruire un CSS differito specifico per pagina con Elementor introdurrebbe una fragilità importante a ogni modifica effettuata dall’editor.
- Rimane un CLS preesistente su una pagina prezzi. È dovuto al font swap su alcuni blocchi di testo larghi e richiederà un font di fallback con metriche allineate. È un intervento separato che potrà essere applicato in maniera sistematica al sito.
I risultati
Sulla home mobile, dopo gli interventi, tre analisi distinte effettuate nella stessa sessione hanno mostrato risultati sensibilmente migliori rispetto alla configurazione senza Nitropack.
| Metrica | Prima, senza Nitropack | Dopo |
|---|---|---|
| Punteggio mobile | 76-86 | 98 |
| First Contentful Paint | 2,0-2,4 s | 1,5 s |
| Largest Contentful Paint | 3,8-5,3 s | 2,3 s |
| Speed Index | 3,3-5,0 s | 1,5-1,8 s |
| Total Blocking Time | 0-100 ms | 3-50 ms |
| Cumulative Layout Shift | 0 | 0 |
| Ritardo rendering LCP | 1.050-2.112 ms | 130 ms |
| Documento HTML compresso | 128 KB | 62 KB |
Su desktop siamo arrivati a 100 punti.
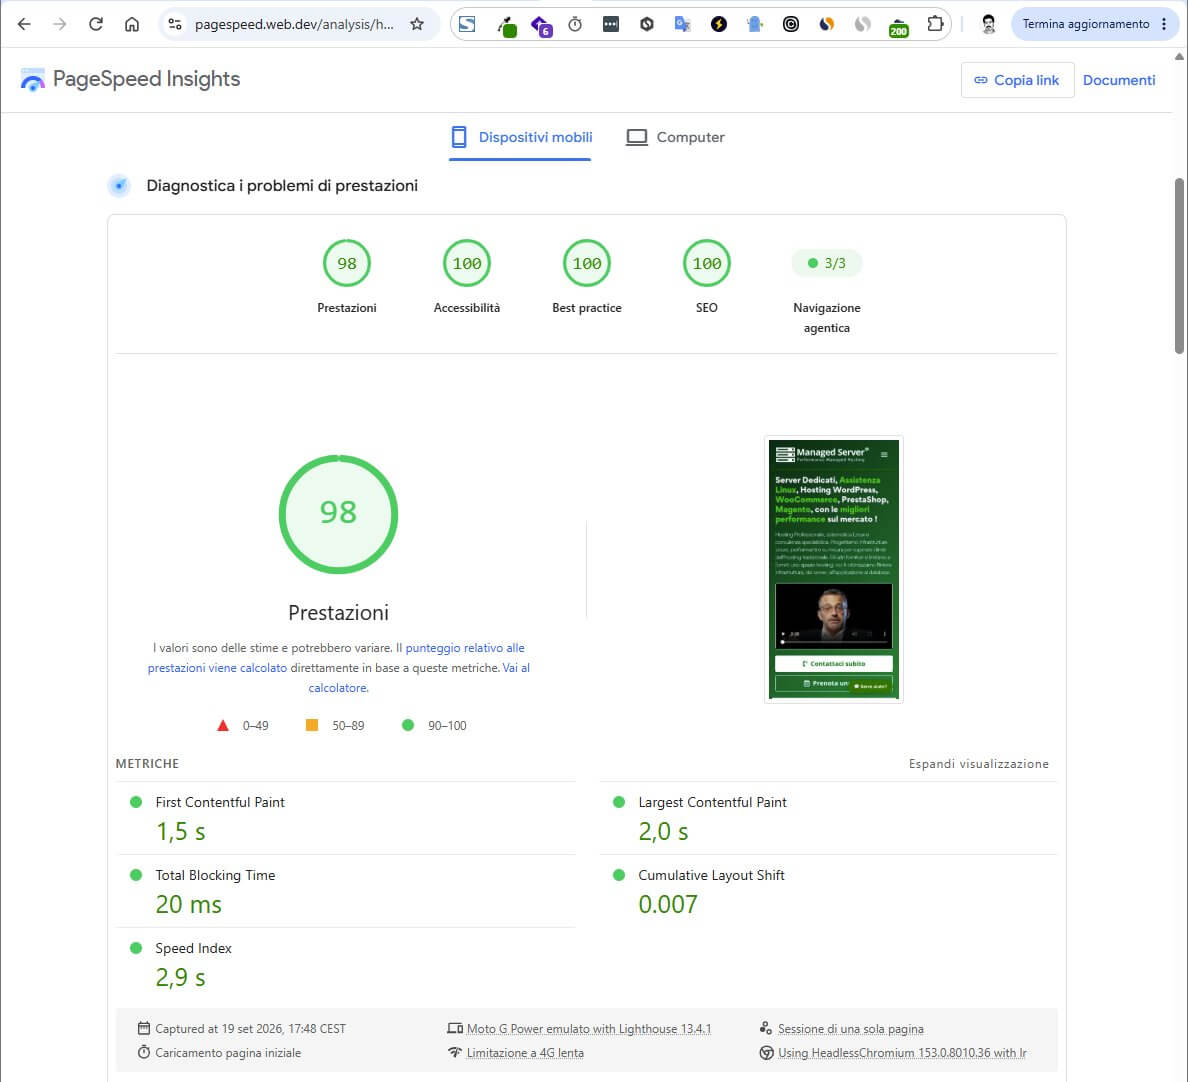
I dati di campo sono rimasti verdi, come lo erano già in precedenza. La differenza è che oggi abbiamo un frontend più leggero, uno stack più prevedibile e soprattutto sappiamo esattamente dove sono stati eliminati i colli di bottiglia e perché ogni intervento produce un beneficio.
La home trasferisce inoltre circa 60 KB in meno di HTML compresso. Su una connessione mobile lenta, a differenza di un semplice miglioramento cosmetico del punteggio, sono byte che l’utente non deve realmente scaricare.
E l’abbonamento a Nitropack non è stato rinnovato.
Quanto lavoro richiede realmente un’ottimizzazione di questo tipo?
C’è infine un aspetto che vale la pena chiarire, soprattutto perché dall’esterno un lavoro di questo tipo può essere facilmente confuso con l’installazione di un plugin di cache o con qualche modifica effettuata in un pomeriggio.
Nel nostro caso abbiamo impiegato circa 20 ore piene di lavoro tecnico effettivo, distribuite tra misurazioni, analisi dei trace, sviluppo delle soluzioni, test, verifiche comparative, modifiche al frontend, interventi sullo stack nginx/Varnish, debug e controlli finali.
Non sono 20 ore trascorse a fare tentativi casuali su PageSpeed Insights. Sono ore di attività specialistica che richiedono competenze contemporaneamente su browser performance, WordPress, Elementor, CSS, JavaScript, nginx, Varnish, caching HTTP, compressione e analisi sistemistica.
Ed è importante anche attribuire un valore realistico a questo tipo di intervento.
Considerando una tariffa media di mercato nell’ordine degli 80 euro l’ora per attività tecniche specialistiche di questo livello, un lavoro equivalente difficilmente potrebbe essere venduto a meno di 1.600 euro + IVA.
Il calcolo è estremamente semplice: 20 ore × 80 €/ora = 1.600 € + IVA.
Questo aiuta anche a capire perché non abbia molto senso confrontare direttamente una vera ottimizzazione manuale con il costo mensile o annuale di un servizio automatico. Sono due prodotti diversi.
Un servizio automatizzato può essere economicamente conveniente perché applica logiche standardizzate a migliaia di siti che producono un effetto cosmetico ed un punteggio verde ottenuto barando e che non porta un reale valore al visitatore. Un intervento manuale, invece, significa analizzare quel determinato sito, capire dove vengono realmente spesi byte e millisecondi, intervenire sul codice e sull’infrastruttura, verificare gli effetti collaterali e scegliere deliberatamente anche quali ottimizzazioni non fare.
Nel nostro caso il risultato non è soltanto un punteggio PageSpeed più alto. Ci rimangono anche tutte le modifiche all’infrastruttura, il critical CSS delle pagine, il nuovo sistema per gli SVG, le ottimizzazioni dei font, la logica di caching, la gestione delle compressioni, il nuovo warmup e soprattutto la conoscenza tecnica su questo sito specifico accumulata durante il processo di ottimizzazione sartoriale.
È questa la differenza tra acquistare un punteggio e acquistare – o realizzare internamente – un lavoro di performance engineering.
Cosa ci portiamo a casa
- Un buon punteggio deve rappresentare un sito realmente veloce. Se una tecnica migliora esclusivamente ciò che vede il tester ma non riduce il lavoro che deve sostenere il visitatore, vale la pena chiedersi se si stia ottimizzando il sito o soltanto la misurazione.
- La dimensione del documento HTML conta moltissimo. Prima di concentrarsi esclusivamente su JavaScript e font conviene misurare anche il documento. Nel nostro caso una parte enorme dell’HTML era costituita semplicemente da icone SVG inline.
- Ogni intervento deve essere misurato più volte. Abbiamo scartato diverse ottimizzazioni apparentemente ovvie perché i numeri mostravano un rapporto costo-beneficio sfavorevole.
- Lo stack conta quanto il frontend. Un problema di keepalive tra Varnish e nginx causava timeout casuali da molto tempo. Nessun plugin di ottimizzazione WordPress avrebbe potuto individuarlo, perché il problema era a un livello completamente diverso.
- La vera ottimizzazione richiede competenze trasversali. Frontend, browser, server web, cache, compressione, PHP e WordPress non possono sempre essere trattati come compartimenti separati ne dal sistemista ne dallo sviluppatore web.
- Serve tempo. Nel nostro caso sono state necessarie circa 20 ore piene di lavoro tecnico. Valorizzate a una tariffa media di mercato di 80 €/ora equivalgono ad almeno 1.600 € + IVA di attività professionale. Non perché il risultato debba essere necessariamente costoso, ma perché dietro un’ottimizzazione reale ci sono analisi, competenze, prove e responsabilità che un pulsante “Optimize” non può sostituire.
Alla fine abbiamo ottenuto quello che cercavamo: abbiamo eliminato un servizio esterno in abbonamento, alleggerito realmente il sito, migliorato le metriche di laboratorio e reso più solida l’infrastruttura sottostante.
E soprattutto, oggi quando PageSpeed Insights restituisce 98 su mobile e 100 su desktop, sappiamo esattamente da dove arrivano quei numeri e che sono numeri reali e non dei falsi ottenuti barando.
Non sono il risultato di una scorciatoia.
Sono il risultato di un sito che abbiamo misurato, analizzato e ottimizzato pezzo per pezzo, la consapevolezza che per quanto si possa ottimizzare lato server ci sarà sempre ampio margine di ottimizzazione lato applicativo HTML / CSS e JS e che ogni caso è un caso a se da risolvere in modo sartoriale.

