
Indice dei contenuti dell'articolo:
C’è un paradosso piuttosto diffuso tra chi si occupa di ottimizzazione delle Web Performance: da una parte si riconosce giustamente l’importanza dei dati reali degli utenti, dall’altra si arriva spesso alla conclusione che gli unici dati che contano siano quelli CrUX e che, di conseguenza, i dati di laboratorio possano essere tranquillamente ignorati.
È un approccio apparentemente logico, ma tecnicamente incompleto.
Se un sito supera i Core Web Vitals sulla base dei dati reali raccolti da Chrome, perché dovremmo preoccuparci di un test Lighthouse che magari restituisce un Largest Contentful Paint più lento, un Total Blocking Time elevato o uno score Performance non particolarmente brillante?
La risposta è che CrUX e LABS non misurano esattamente la stessa cosa e, soprattutto, non servono allo stesso scopo.
I dati sul campo ci dicono cosa è successo realmente agli utenti che hanno visitato il sito. I dati di laboratorio ci permettono invece di capire come si comporta quella pagina quando viene sottoposta a condizioni controllate, ripetibili e potenzialmente più critiche.
Ignorare uno dei due significa rinunciare volontariamente a una parte importante dell’informazione.
Il falso mito: “se i dati CrUX sono buoni, il sito è veloce”
Il ragionamento che sentiamo spesso è più o meno questo: Google valuta i Core Web Vitals utilizzando dati reali, quindi l’unica cosa importante è superare la valutazione CrUX. Se PageSpeed Insights mostra dati sul campo verdi, quello che succede nella sezione Lighthouse diventa secondario o addirittura irrilevante.
Il problema nasce dal fatto che si confondono due concetti diversi: la misurazione di ciò che è successo e la diagnosi di ciò che potrebbe succedere.
Il Chrome User Experience Report, comunemente chiamato CrUX, raccoglie infatti dati provenienti dalle esperienze reali di utenti Chrome idonei e li aggrega per URL o per origine.
Se volete approfondire le differenze tra metriche e modalità di misurazione, vi consigliamo anche il nostro approfondimento sui Core Web Vitals e dati CrUX.
C’è però una precisazione fondamentale: CrUX non è semplicemente una media delle prestazioni del sito.
Per la valutazione dei Core Web Vitals viene utilizzato il 75° percentile. In termini semplici significa che, per una determinata metrica, almeno il 75% delle esperienze registrate deve avere un valore uguale o migliore di quello riportato.
Attualmente le tre metriche Core Web Vitals sono:
- LCP – Largest Contentful Paint, con una soglia “Good” fino a 2,5 secondi;
- INP – Interaction to Next Paint, con una soglia “Good” fino a 200 millisecondi;
- CLS – Cumulative Layout Shift, con una soglia “Good” fino a 0,1.
Questo sistema è molto più significativo di una semplice media perché limita l’effetto degli outlier. Tuttavia, proprio perché stiamo parlando di una distribuzione statistica, un buon valore CrUX non significa automaticamente che ogni utente stia navigando velocemente.
Il problema della popolazione che stiamo osservando
Facciamo un esempio volutamente semplice.
Immaginiamo un sito italiano il cui traffico provenga per la grandissima maggioranza da Milano, Roma e altre grandi città. Supponiamo inoltre che buona parte di questi visitatori utilizzi smartphone recenti collegati tramite fibra, Wi-Fi veloce o reti mobili 5G con latenze contenute.
Quella sarà la popolazione predominante all’interno delle esperienze raccolte.
Se il 90% degli utenti naviga in condizioni particolarmente favorevoli, è perfettamente possibile ottenere valori CrUX eccellenti anche se la pagina, dal punto di vista assoluto, è tutt’altro che leggera.
Ora immaginiamo di aprire esattamente lo stesso sito da una zona rurale o montana della Sardegna, dell’Appennino o di qualsiasi altro territorio in cui la connettività mobile sia meno performante, magari attraverso una rete 4G congestionata, con maggiore latenza e uno smartphone di fascia medio-bassa.
L’esperienza può diventare completamente diversa.
Un’immagine hero da 800 KB, quattro font caricati da domini esterni, 700 KB di JavaScript, una piattaforma di advertising, uno script di consent management, un sistema di tracking e vari widget di terze parti possono risultare quasi invisibili su una connessione molto veloce, mentre diventano estremamente evidenti quando aumentano latenza, tempo di download e capacità di elaborazione richiesta al dispositivo.
Il sito non è improvvisamente diventato più pesante: era pesante anche prima. Semplicemente la qualità della connessione e dell’hardware prevalenti nel campione reale ne stavano attenuando gli effetti.
Naturalmente l’esempio geografico serve a rendere evidente il concetto: le differenze non dipendono soltanto dalla città o dalla regione. Contano il dispositivo, la potenza della CPU, la rete utilizzata, la latenza, il carico del dispositivo, la cache, il browser, il comportamento dell’utente e numerosi altri fattori.
CrUX descrive i vostri utenti, non tutti gli utenti possibili
Questo è probabilmente il punto più importante dell’intera questione.
I dati CrUX sono rappresentativi delle esperienze effettivamente raccolte per quel sito, non di qualsiasi possibile condizione di navigazione.
Ed è esattamente così che deve essere.
Il compito dei field data è raccontarci ciò che succede nel mondo reale. Sarebbe sbagliato pretendere che facessero qualcosa di diverso.
Il problema nasce quando trasformiamo questa caratteristica in una conclusione assoluta e diciamo: “CrUX è verde, quindi il sito è veloce e non devo indagare oltre”.
La frase corretta dovrebbe essere:
“CrUX è verde, quindi almeno il 75% delle esperienze raccolte per le metriche considerate rientra attualmente nelle soglie Good.”
È un’affermazione molto diversa.
Tra l’altro, PageSpeed Insights mostra dati CrUX relativi a una finestra degli ultimi 28 giorni. Questo significa che il field data possiede inevitabilmente anche una componente storica.
Se oggi introduciamo una modifica che peggiora sensibilmente le prestazioni di una pagina, il dato LAB può evidenziarlo immediatamente. Il dato CrUX, invece, dovrà progressivamente incorporare le nuove esperienze degli utenti.
Ancora una volta: non è un difetto di CrUX. È semplicemente conseguenza del modo in cui funziona una misurazione aggregata nel tempo.
A cosa servono realmente i dati LABS?
I dati di laboratorio rispondono a una domanda diversa.
Invece di chiederci “come hanno navigato realmente i nostri visitatori?”, ci consentono di chiederci:
“Come si comporta questa pagina se eliminiamo parte delle variabili esterne e la sottoponiamo a uno scenario riproducibile?”
Lighthouse, utilizzato anche da PageSpeed Insights per la sezione di laboratorio, esegue infatti l’analisi all’interno di un ambiente controllato.
Questo permette di individuare problemi tecnici che potrebbero essere difficili da osservare guardando solamente il dato aggregato CrUX: risorse render-blocking, JavaScript eccessivo, long task sul main thread, immagini sovradimensionate, problemi nella catena di caricamento dell’elemento LCP, richieste di rete inutili, CSS non utilizzato, script di terze parti e numerose altre criticità.
Il grande vantaggio del laboratorio è la ripetibilità.
Se effettuiamo una modifica e vogliamo capire se abbiamo migliorato o peggiorato il caricamento della pagina, possiamo eseguire test prima e dopo mantenendo condizioni comparabili.
Con i dati reali questa immediatezza non è possibile, perché cambiano continuamente utenti, reti, dispositivi e comportamenti.
LABS non significa “dato finto”
Un altro errore frequente consiste nell’associare il termine “synthetic” o “lab” a qualcosa di artificiale e quindi poco significativo.
È vero che un test Lighthouse non può rappresentare perfettamente tutta la varietà del traffico reale. Ma non è questo il suo obiettivo.
Un crash test automobilistico non riproduce ogni possibile incidente che avverrà nel mondo reale. Eppure nessuno concluderebbe che, proprio per questo motivo, i crash test siano inutili.
Allo stesso modo un benchmark di laboratorio ci permette di mettere il sistema in una condizione nota e osservare come reagisce.
Se un sito mantiene un LCP eccellente, un carico JavaScript contenuto e un main thread libero anche in condizioni più severe rispetto a quelle vissute normalmente dalla maggioranza dei suoi utenti, abbiamo costruito un sito con un margine prestazionale maggiore.
Ed è proprio quel margine che può fare la differenza quando cambiano le condizioni.
Il margine prestazionale è ciò che spesso non vediamo nei dati CrUX
Prendiamo due siti che mostrano entrambi un LCP CrUX di 2 secondi.
Il primo è tecnicamente molto ottimizzato: HTML generato rapidamente, caching efficace, immagini compresse correttamente, poche risorse critiche, JavaScript ridotto e infrastruttura server con tempi di risposta molto contenuti.
Il secondo raggiunge gli stessi 2 secondi grazie soprattutto al fatto che il pubblico utilizza prevalentemente hardware recente e connessioni molto veloci. La pagina pesa parecchi megabyte e richiede una quantità importante di JavaScript.
Guardando esclusivamente il numero CrUX potremmo concludere che i due siti siano equivalenti.
Dal punto di vista dell’ingegneria delle performance non lo sono affatto.
Al primo basta poco per continuare a funzionare bene anche quando le condizioni peggiorano. Il secondo dispone di un margine molto inferiore e può degradare velocemente quando aumentano latenza, congestione della rete o carico della CPU.
Il dato LAB aiuta precisamente a rendere visibile questo margine.
Cosa succede quando LABS è rosso e CrUX è verde?
È probabilmente la situazione che genera più discussioni.
Il sito supera i Core Web Vitals sul campo ma Lighthouse segnala prestazioni mediocri.
Bisogna intervenire?
Non necessariamente su qualsiasi singolo warning e certamente non inseguendo ossessivamente il punteggio 100 di Lighthouse. Il Performance Score non deve diventare un fine in sé.
Tuttavia sarebbe un grave errore ignorare completamente il report.
Un dato LAB sensibilmente negativo può indicare che il sito possiede poco margine prestazionale (ed un ampio margine di miglioramento) e che le buone performance reali dipendono, almeno in parte, dalle condizioni favorevoli della propria utenza.
In questa situazione conviene capire perché il laboratorio sta riportando valori peggiori.
Se emergono 2 MB di JavaScript, immagini enormi, richieste bloccanti o un LCP che dipende da una lunga sequenza di risorse, il fatto che gli utenti attuali riescano a compensare questi problemi grazie a connessioni e dispositivi veloci non li trasforma in buone pratiche.
E quando LABS è verde ma CrUX è rosso?
È possibile anche la situazione opposta.
Lighthouse restituisce risultati eccellenti, ma i dati reali mostrano LCP, CLS o INP insufficienti.
In questo caso il laboratorio ci sta dicendo che, nello scenario controllato utilizzato dal test, la pagina si comporta correttamente. CrUX ci sta invece dicendo che nel mondo reale qualcosa va storto.
Potrebbero entrare in gioco elementi che il singolo caricamento LAB non riesce a rappresentare adeguatamente: interazioni successive al caricamento, contenuti personalizzati, cookie banner, pubblicità, script caricati soltanto in determinate condizioni, device molto lenti oppure comportamenti reali degli utenti.
Per esempio l’INP dipende dalle interazioni effettive con la pagina. Un semplice caricamento sintetico non può riprodurre automaticamente tutte le azioni che migliaia di utenti compiono durante le proprie sessioni.
In casi simili il dato CrUX diventa il punto di partenza per cercare un problema che il laboratorio dovrà poi tentare di riprodurre e diagnosticare.
Il workflow corretto è CrUX → LABS → ottimizzazione → CrUX
Il vero errore è quindi cercare di stabilire quale delle due famiglie di dati sia “quella giusta”.
Sono giuste entrambe perché rispondono a domande differenti.
Un workflow sensato di ottimizzazione dovrebbe utilizzare i field data per individuare il problema e valutarne l’impatto reale, quindi utilizzare gli strumenti di laboratorio per comprenderne le cause tecniche.
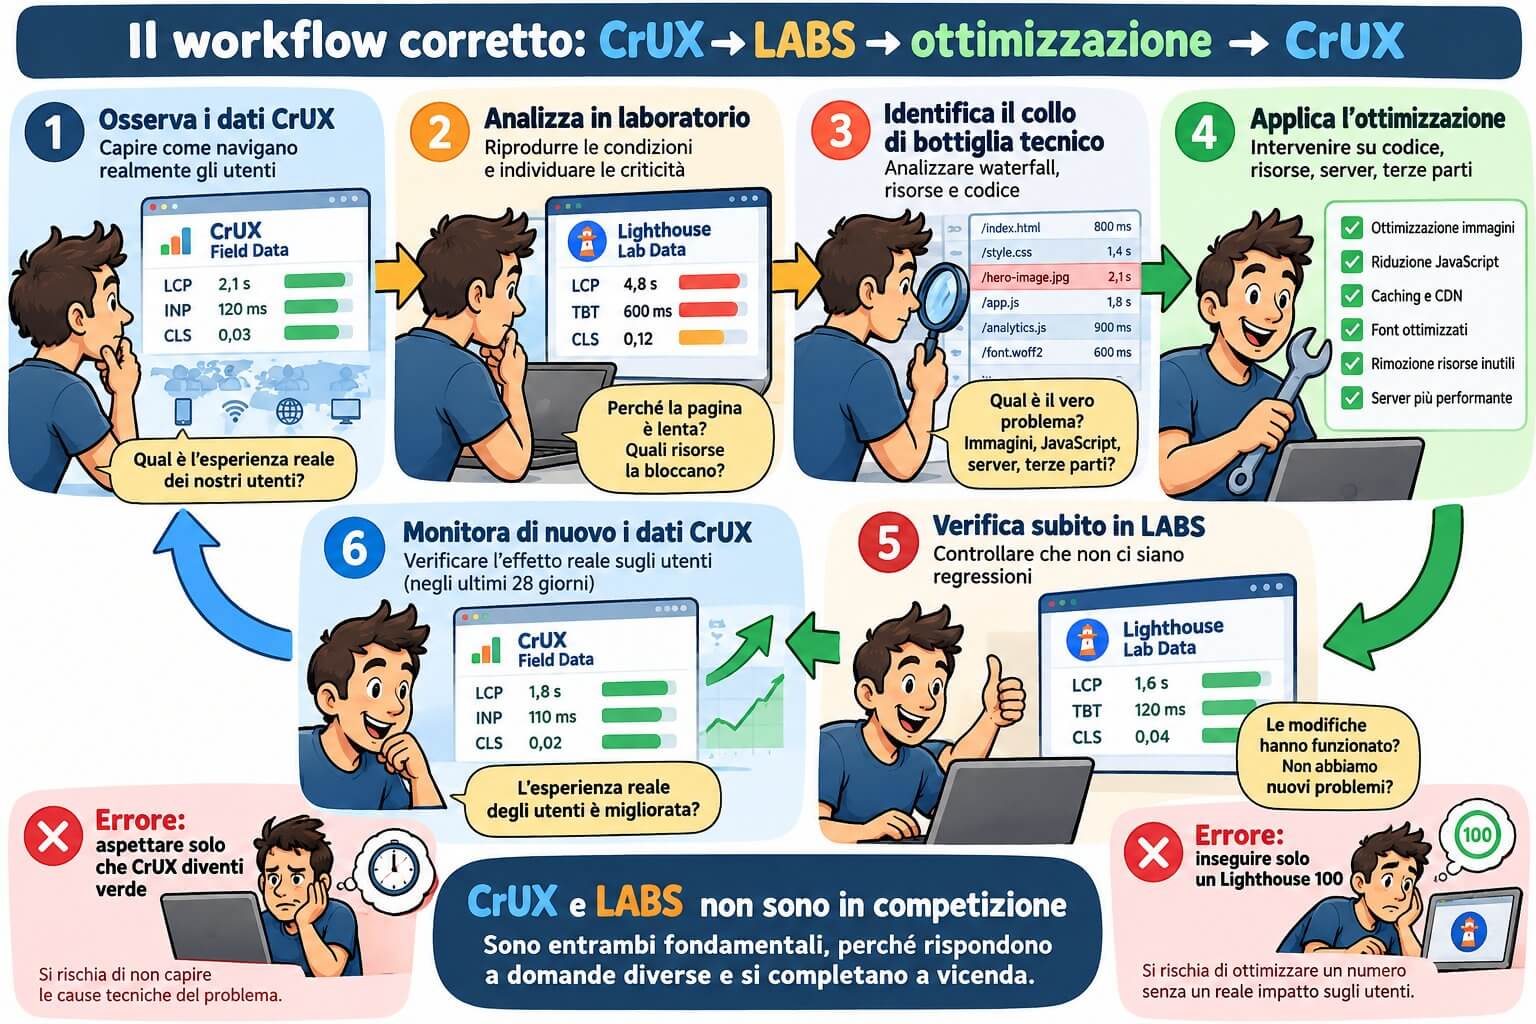
Possiamo riassumere il processo in questo modo:
- osservare i dati CrUX e capire come stanno realmente navigando gli utenti;
- analizzare la pagina in laboratorio cercando di riprodurre le condizioni problematiche;
- identificare il collo di bottiglia tecnico;
- applicare l’ottimizzazione;
- verificare immediatamente in LABS che non siano state introdotte regressioni;
- monitorare successivamente i dati reali per verificare l’effetto della modifica sugli utenti.
Questo approccio è molto più razionale che limitarsi ad aggiornare PageSpeed Insights aspettando che il riquadro CrUX diventi verde oppure, all’estremo opposto, inseguire compulsivamente un Lighthouse 100 senza domandarsi se l’intervento abbia un impatto percepibile sugli utenti.
Non dimentichiamo server, hosting e Time To First Byte
C’è poi un altro aspetto che per noi, occupandoci quotidianamente di hosting e sistemistica Linux, è particolarmente importante.
Una buona Web Performance nasce dall’intero stack, non soltanto dall’ottimizzazione del frontend.
Il browser non può iniziare realmente a costruire una pagina che il server non ha ancora iniziato a consegnare.
Un’applicazione WordPress con query SQL inefficienti, PHP sovraccarico, assenza di page caching, object cache configurata male o un’infrastruttura server sottodimensionata può aumentare significativamente il tempo necessario per iniziare a ricevere il documento HTML.
Il TTFB non è di per sé uno dei tre Core Web Vitals, ma un tempo di risposta server elevato può propagarsi lungo tutta la catena di caricamento e contribuire, in particolare, a peggiorare il Largest Contentful Paint.
In presenza di utenti vicini geograficamente al server e dotati di connessioni eccellenti, una parte di queste inefficienze può risultare meno evidente. Non per questo smette di esistere.
Quando effettuiamo test controllati da differenti condizioni di rete e analizziamo waterfall, TTFB, resource loading e dipendenze critiche, possiamo separare meglio le responsabilità del backend da quelle del frontend.
Ed è esattamente ciò che serve quando l’obiettivo non è semplicemente ottenere un bollino verde, ma costruire un sito realmente robusto dal punto di vista prestazionale.
Curare i dati LABS per proteggersi da attacchi ai Core Web Vitals
C’è infine un aspetto meno discusso, ma interessante proprio perché dimostra quanto sia pericoloso progettare un sito contando esclusivamente sulle condizioni medie della propria utenza: la possibilità che la composizione del traffico reale cambi improvvisamente, anche in modo non spontaneo.
In linea teorica, infatti, un sito che mostra ottimi Core Web Vitals soprattutto perché viene visitato da utenti geograficamente vicini al datacenter, dotati di connessioni veloci e dispositivi moderni, è più vulnerabile a un forte afflusso di visitatori provenienti da condizioni di rete completamente differenti.
Questo scenario può verificarsi naturalmente, per esempio in seguito a una campagna internazionale, a un contenuto diventato virale o a una improvvisa crescita del traffico da un determinato Paese. Ma è possibile immaginare anche uno scenario avverso nel quale qualcuno utilizzi normali strumenti di acquisizione del traffico per generare intenzionalmente una grande quantità di visite provenienti da mercati nei quali il costo pubblicitario è molto basso e le condizioni medie di connettività sono peggiori.
L’acquisto di traffico pubblicitario è ovviamente un’attività ordinaria e legittima in sé; l’eventuale utilizzo intenzionale per danneggiare un concorrente è un discorso differente e può dipendere dalle modalità utilizzate, dalle condizioni delle piattaforme pubblicitarie e dalle normative applicabili. Il punto interessante, dal punto di vista delle Web Performance, non è però come realizzare un’operazione di questo tipo, ma comprendere perché un’infrastruttura poco ottimizzata possa risultare più esposta a un cambiamento artificiale del proprio mix di utenti.
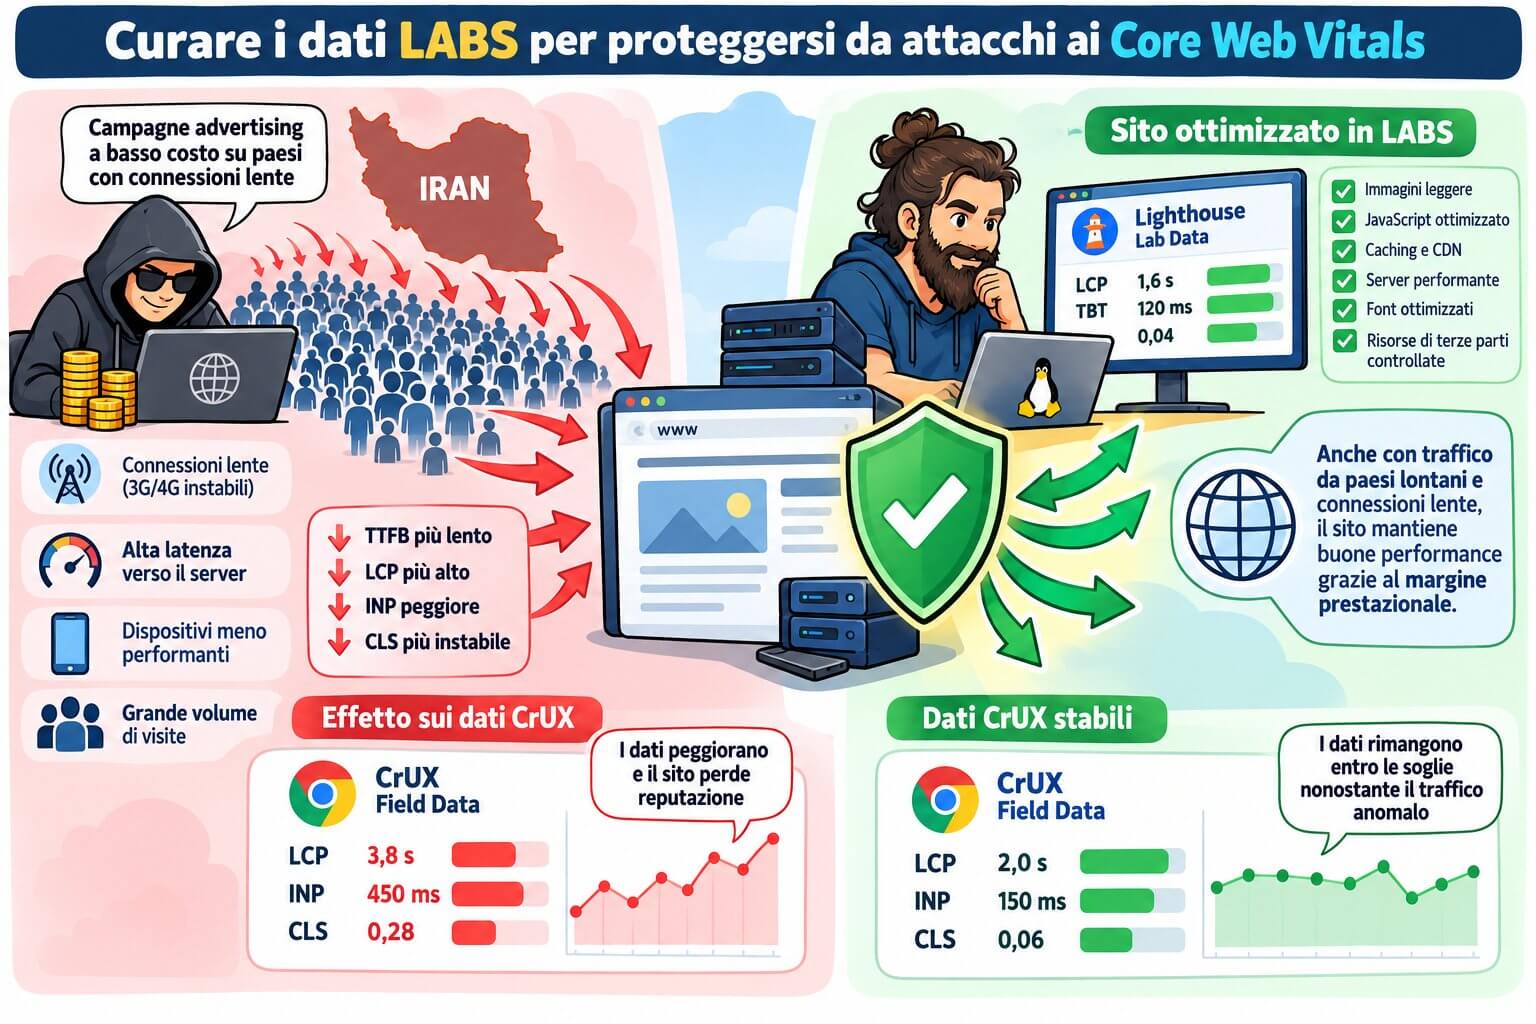
Immaginiamo, per esempio, un sito italiano ospitato esclusivamente in Europa che riceva improvvisamente un volume molto elevato di visite da un Paese geograficamente distante, con latenze superiori e una quota significativa di connessioni mobili meno performanti. Potremmo pensare, a titolo di esempio, all’Iran o più genericamente a mercati nei quali una parte rilevante dell’utenza naviga in condizioni di rete sensibilmente diverse da quelle del pubblico italiano urbano.
Questi utenti potrebbero sperimentare latenza maggiore, download più lenti e tempi di caricamento superiori. Anche il TTFB osservato dal browser potrebbe aumentare per effetto della distanza geografica e della latenza della rete, e questo potrebbe a sua volta ritardare il caricamento delle risorse necessarie alla visualizzazione dell’elemento LCP.
Chrome UX Report non utilizza tutte le visite effettuate a una pagina. Solo una parte degli utenti Chrome soddisfa i criteri previsti per contribuire al dataset CrUX. Inoltre le metriche non vengono calcolate facendo una semplice media aritmetica di tutte le visite, ma analizzando una distribuzione e utilizzando il 75° percentile.
Di conseguenza non esiste una formula del tipo “X visite lente equivalgono a Y punti persi”. Dispositivo, browser, eleggibilità dell’utente a CrUX, distribuzione geografica, quantità di traffico abituale del sito e performance effettivamente osservate sono tutte variabili determinanti.
Ciò non toglie che, se una quantità sufficientemente significativa delle nuove esperienze entra realmente nel dataset CrUX e presenta prestazioni peggiori, la distribuzione dei field data può cambiare.
Ed è qui che torna centrale il tema dei dati LABS.
Un sito che nei test di laboratorio possiede già poco margine, per esempio con un LCP vicino alla soglia dei 2,5 secondi in condizioni simulate, centinaia di richieste, JavaScript eccessivo e immagini molto pesanti, dipende fortemente dalla qualità della rete e del dispositivo dell’utente. Quando quelle condizioni favorevoli vengono meno, il rischio di superare le soglie aumenta rapidamente.
Al contrario, un sito progettato per ottenere buoni valori LABS anche in scenari di rete e CPU più severi dispone di una sorta di riserva prestazionale. Se la latenza aumenta di 100 o 200 millisecondi, se la banda disponibile diminuisce oppure se arriva improvvisamente traffico da dispositivi meno potenti, il sito ha maggiori probabilità di restare comunque entro valori accettabili.
Curare i LABS diventa quindi anche una forma di hardening prestazionale.
Non significa difendersi da un fantomatico algoritmo o sostenere che campagne di negative SEO basate sui Core Web Vitals siano sempre efficaci. Non esiste alcuna garanzia che un tentativo del genere produca un determinato risultato e i Core Web Vitals rappresentano soltanto una parte dei numerosi segnali utilizzati dai sistemi di ranking.
Significa piuttosto evitare di costruire un sito che funziona bene soltanto finché rimangono immutate le condizioni statistiche favorevoli del suo pubblico.
Se per ottenere Core Web Vitals verdi avete bisogno che quasi tutti i visitatori dispongano di fibra, 5G, smartphone recenti e bassa latenza verso il vostro server, non avete costruito un sito realmente veloce: avete costruito un sito che appare veloce all’interno di uno scenario favorevole.
Un’ottimizzazione seria deve invece puntare a mantenere un margine sufficiente anche quando quello scenario cambia, indipendentemente dal fatto che il cambiamento sia naturale, dovuto a una campagna pubblicitaria, a una crescita internazionale del progetto o a traffico deliberatamente anomalo.
Ottimizzare per il dato o ottimizzare per l’utente?
Alla base di tutto c’è una domanda più generale.
Stiamo ottimizzando un numero oppure stiamo ottimizzando un sistema?
Se l’obiettivo diventa esclusivamente “superare i Core Web Vitals”, è facile cadere nella tentazione di osservare soltanto il dato ufficialmente utilizzato per quella valutazione.
Google stessa, però, mette a disposizione all’interno di PageSpeed Insights sia i dati reali provenienti da CrUX sia quelli di laboratorio di Lighthouse. Non sono due sezioni messe una accanto all’altra per caso: una descrive l’esperienza reale aggregata, l’altra aiuta a diagnosticare i problemi di performance.
I dati CrUX hanno quindi un valore enorme e devono avere un ruolo centrale nell’analisi delle Web Performance. Ma trasformare questa centralità nell’idea che tutto ciò che è LABS sia irrilevante significa perdere uno degli strumenti più utili per prevenire problemi, individuare regressioni e comprendere le cause tecniche di una performance insufficiente.
CrUX e LABS devono essere letti insieme
Il punto finale è quindi semplice.
Non bisogna scegliere tra CrUX e LABS.
Bisogna conoscere i limiti e i vantaggi di entrambi.
CrUX ci dice cosa è successo agli utenti reali del nostro sito, sulle reti e sui dispositivi che hanno effettivamente utilizzato. È indispensabile per comprendere la qualità dell’esperienza reale e rappresenta il riferimento per la valutazione sul campo dei Core Web Vitals.
LABS ci permette invece di creare condizioni controllate, confrontare prima e dopo un intervento, individuare colli di bottiglia e verificare quanto margine prestazionale possiede realmente una pagina.
Se il vostro pubblico naviga quasi esclusivamente attraverso connessioni velocissime e smartphone di ultima generazione, i dati CrUX potrebbero essere ottimi anche in presenza di inefficienze significative.
Questo non significa che CrUX stia sbagliando.
Significa che CrUX sta descrivendo correttamente il pubblico che avete oggi.
Il laboratorio, invece, può aiutarvi a capire cosa potrebbe accadere domani, oppure cosa sta già accadendo a quella parte di utenti che dispone di condizioni meno favorevoli.
La forma mentis corretta per chi si occupa seriamente di Web Performance deve quindi essere questa: dare la massima importanza ai dati reali senza mai smettere di osservare i dati di laboratorio.
Perché un sito realmente veloce non è semplicemente un sito che oggi mostra tre indicatori verdi in PageSpeed Insights.
È un sito progettato per continuare a essere veloce anche quando la rete rallenta, il dispositivo è meno potente, aumenta il traffico o cambiano le condizioni operative.
Ed è proprio nell’unione tra field data, LAB data, analisi applicativa e ottimizzazione sistemistica che possiamo distinguere una semplice ottimizzazione del punteggio da una vera ottimizzazione delle performance.
Eye don’t Lie. Gli occhi non mentono
Alla fine, oltre a PageSpeed Insights, Lighthouse, CrUX e a tutti gli strumenti di analisi disponibili, esiste un metodo estremamente semplice per capire come si comporta davvero un sito: guardarlo con i nostri occhi e usarlo nelle condizioni reali in cui lo usano gli utenti. Provate a navigarlo da smartphone quando siete in un locale affollato, in un pub, in un ristorante, all’interno di un edificio con poca copertura oppure durante una vacanza in una zona dove il segnale mobile non è particolarmente stabile.
È proprio in queste situazioni che emergono ritardi, immagini che compaiono lentamente, elementi che si spostano, interazioni poco reattive e pagine che sembravano velocissime in ufficio ma che, fuori da una rete Wi-Fi performante, mostrano tutti i propri limiti. Naturalmente restano utilissimi anche i classici sistemi di network throttling messi a disposizione da browser come Chrome, che consentono di simulare connessioni più lente e CPU meno potenti, ma nessuna simulazione sostituisce completamente l’esperienza diretta.
Gli occhi non mentono: se un sito vi sembra lento quando lo usate davvero, in condizioni non ideali, è molto probabile che una parte dei vostri utenti stia vivendo esattamente la stessa esperienza. Ed è questo, in definitiva, il senso più concreto della Web Performance: non ottenere soltanto numeri verdi, ma fare in modo che il sito sembri e sia realmente veloce per chi lo utilizza.

