
Indice dei contenuti dell'articolo:
Ogni tanto capita di mettere le mani su un sito di un cliente e trovarci dentro qualcosa che non abbiamo installato noi. Succede spesso: un plugin di terze parti, uno script di marketing, una CDN infilata davanti all’origin da un’agenzia. Quasi sempre è roba innocua. Ogni tanto, invece, vale la pena approfondire.
Negli ultimi mesi ci siamo imbattuti in Tuurbo.ai su due clienti molto diversi fra loro: un e-commerce che vende materiale da ferramenta e fai da te, e un noto network editoriale in ambito calcistico.
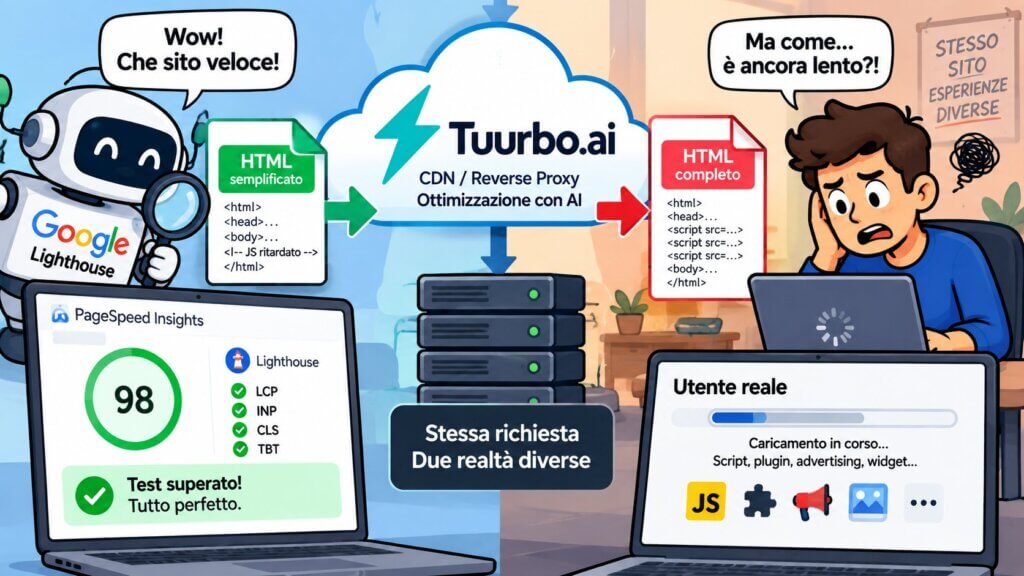
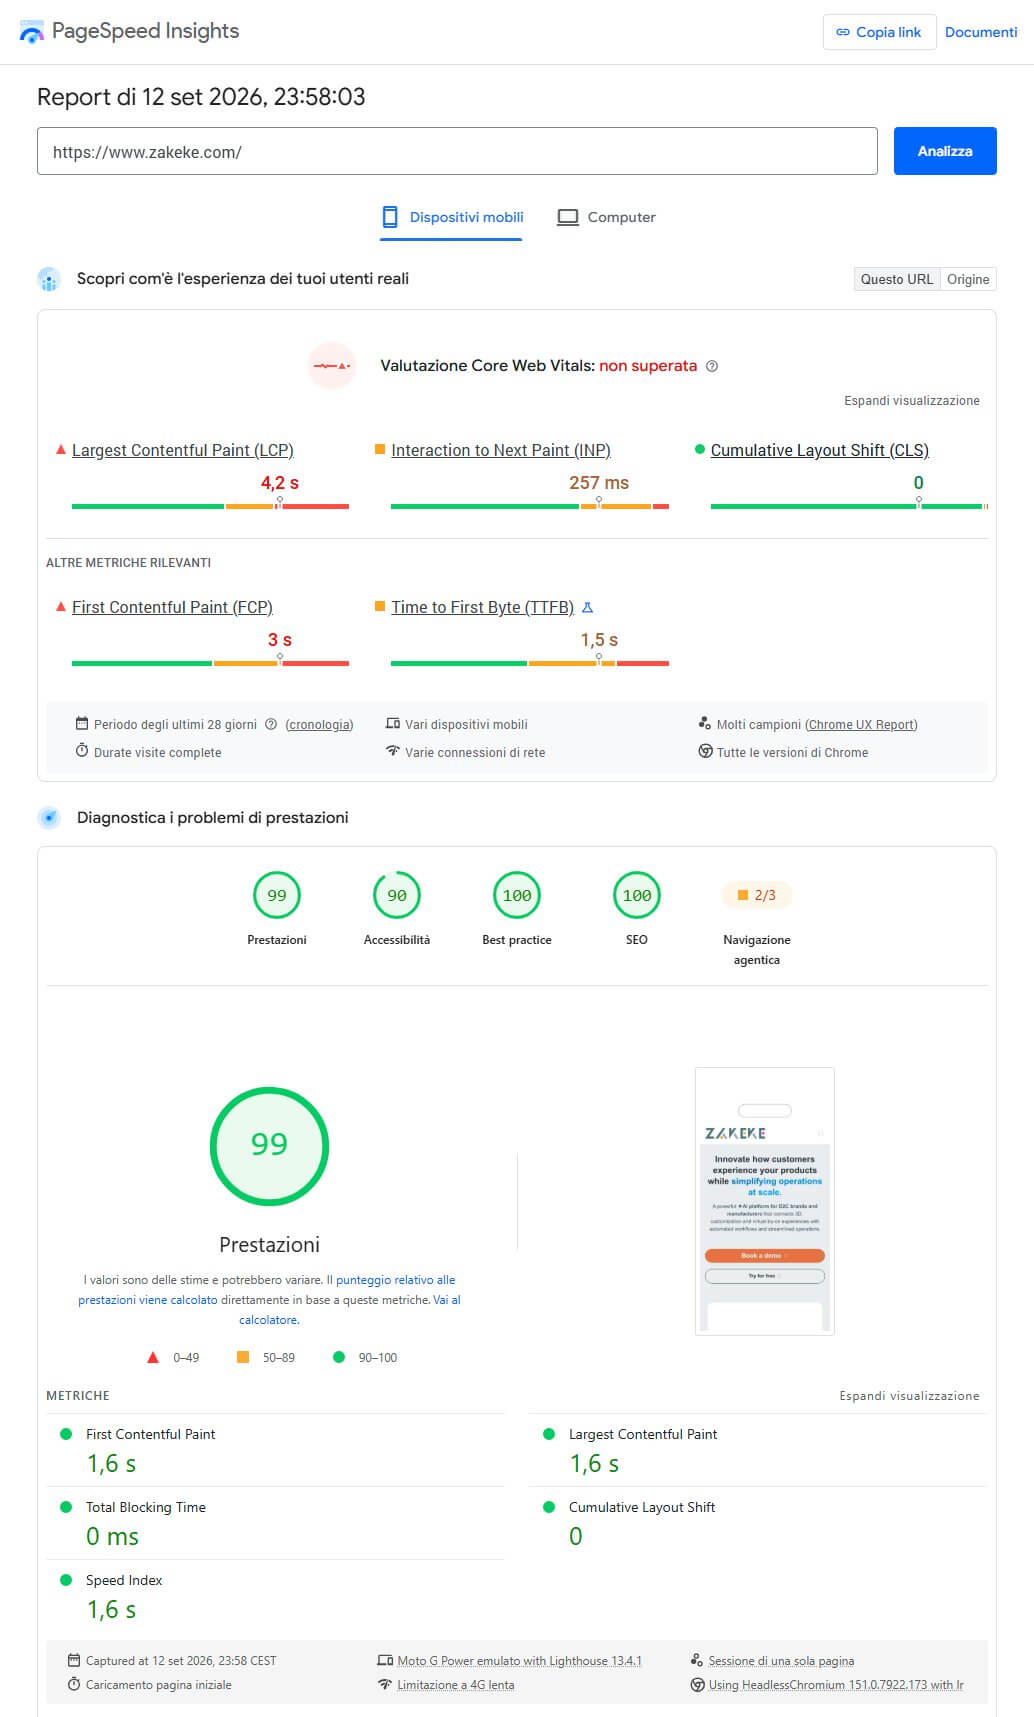
In entrambi i casi la dinamica era sostanzialmente la stessa: punteggi PageSpeed Insights improvvisamente stellari, dashboard Search Console che raccontavano un’altra storia, e un sistemista — noi — chiamato a spiegare come mai il sito “che ha 98 su PageSpeed” continuasse a non superare i Core Web Vitals.
Abbiamo fatto quello che facciamo sempre in questi casi: abbiamo aperto il sorgente e abbiamo iniziato a leggere il codice.
È lo stesso percorso che avevamo già seguito con Kleecks, iSmartframe e le CDN che “ottimizzano” i Core Web Vitals, e le conclusioni, come vedremo, presentano parecchie somiglianze.
Cosa promette Tuurbo.ai?
Tuurbo.ai è un prodotto italiano di Tuurbo S.r.l., con sede ad Aci Sant’Antonio, in provincia di Catania.
Si presenta come una piattaforma no-code basata su “automazione e intelligenza artificiale” che promette di ottimizzare un sito web su quattro aree principali: velocità, SEO on-page, accessibilità e sicurezza.
Il claim della pagina Speed Performance punta esplicitamente sulle metriche di performance e sulla capacità di portare il sito a eccellere nelle valutazioni legate ai Core Web Vitals e a PageSpeed Insights.
La lista dei clienti presentata dall’azienda comprende realtà di dimensioni importanti: Monrif e Quotidiano.net, Il Resto del Carlino, La Nazione, Il Giorno, Zakeke, Farmamia, Jolicì, Imballaggi2000, Riba Mundo e altri.
Ci sono testimonianze firmate da CTO ed e-commerce manager, programmi dedicati ad agenzie e web agency e una sezione di case study.
Insomma, non stiamo parlando di un plugin sconosciuto sviluppato nel fine settimana.
È un prodotto commerciale strutturato, utilizzato anche da aziende importanti.
Proprio per questo, anziché fermarci alle slide commerciali e ai risultati mostrati nei test sintetici, abbiamo preferito capire tecnicamente cosa accadesse tra il server origin, Tuurbo e il browser dell’utente.
Come funziona Tuurbo.ai: CDN, reverse proxy e manipolazione del DOM
Per capire quello che vedremo successivamente nel loader bisogna chiarire un punto fondamentale: Tuurbo.ai non funziona semplicemente aggiungendo un normale JavaScript al sito.
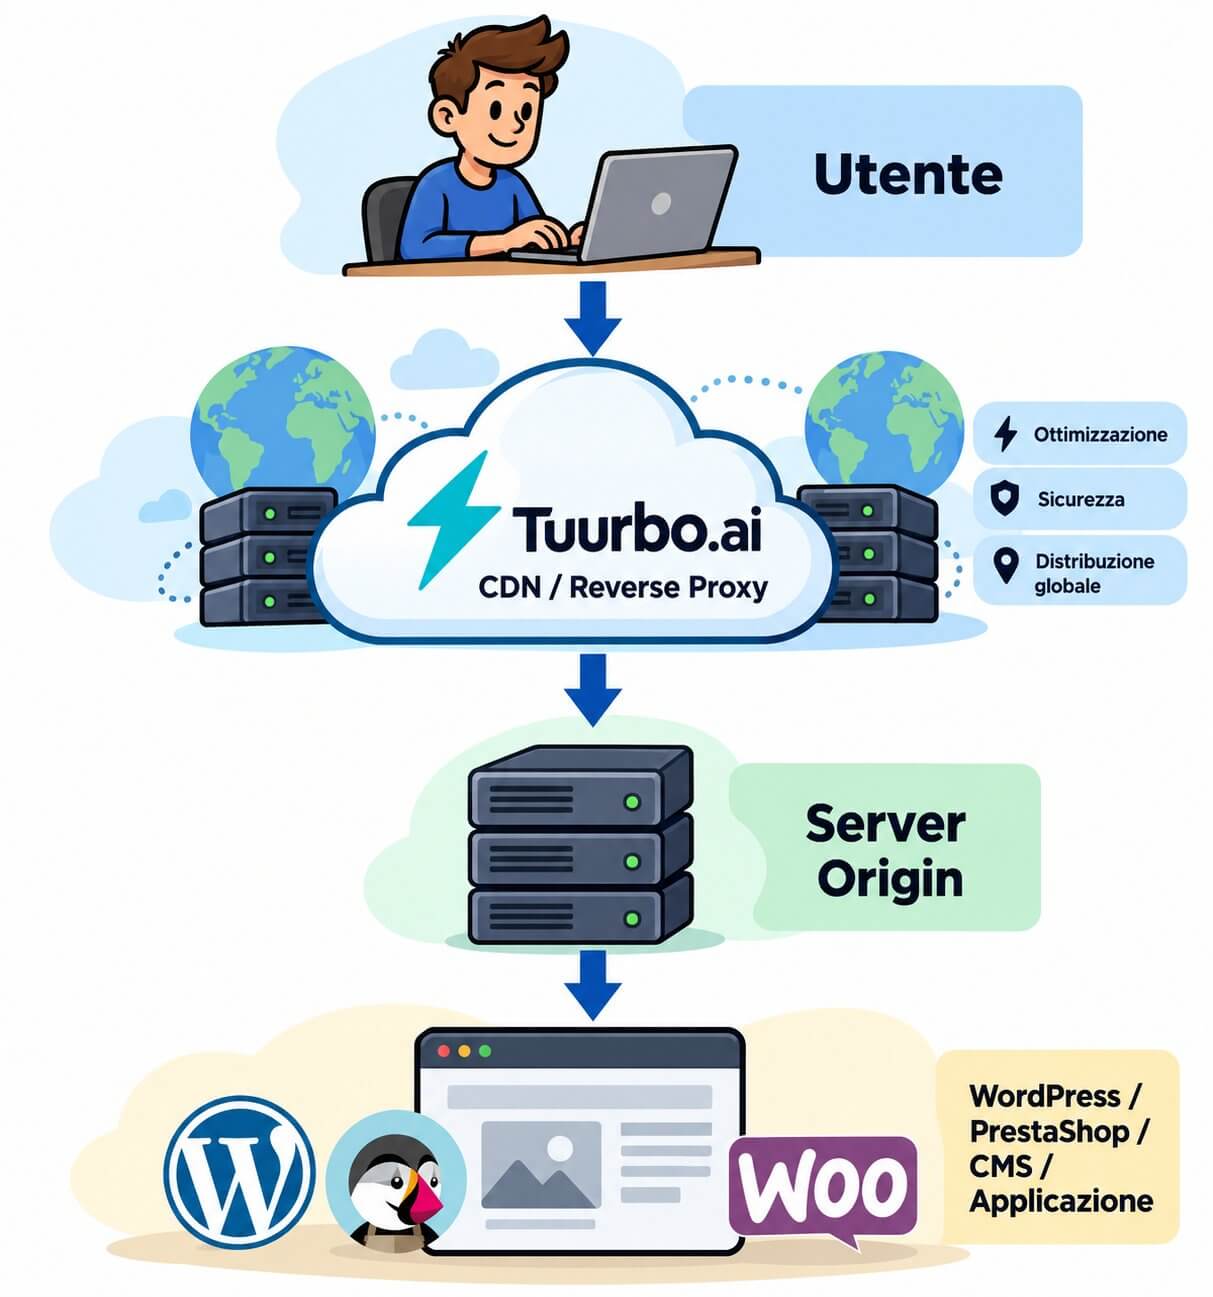
L’architettura comprende un layer intermedio che si posiziona tra il server origin e il visitatore.
In termini infrastrutturali possiamo descriverlo come un sistema basato su CDN e reverse proxy.
Quando un utente richiede una pagina, la richiesta può quindi transitare attraverso l’infrastruttura intermedia prima di raggiungere il server che ospita realmente WordPress, PrestaShop, WooCommerce o l’applicazione del cliente.
In modo molto semplificato:
Il punto interessante arriva soprattutto nel percorso inverso.
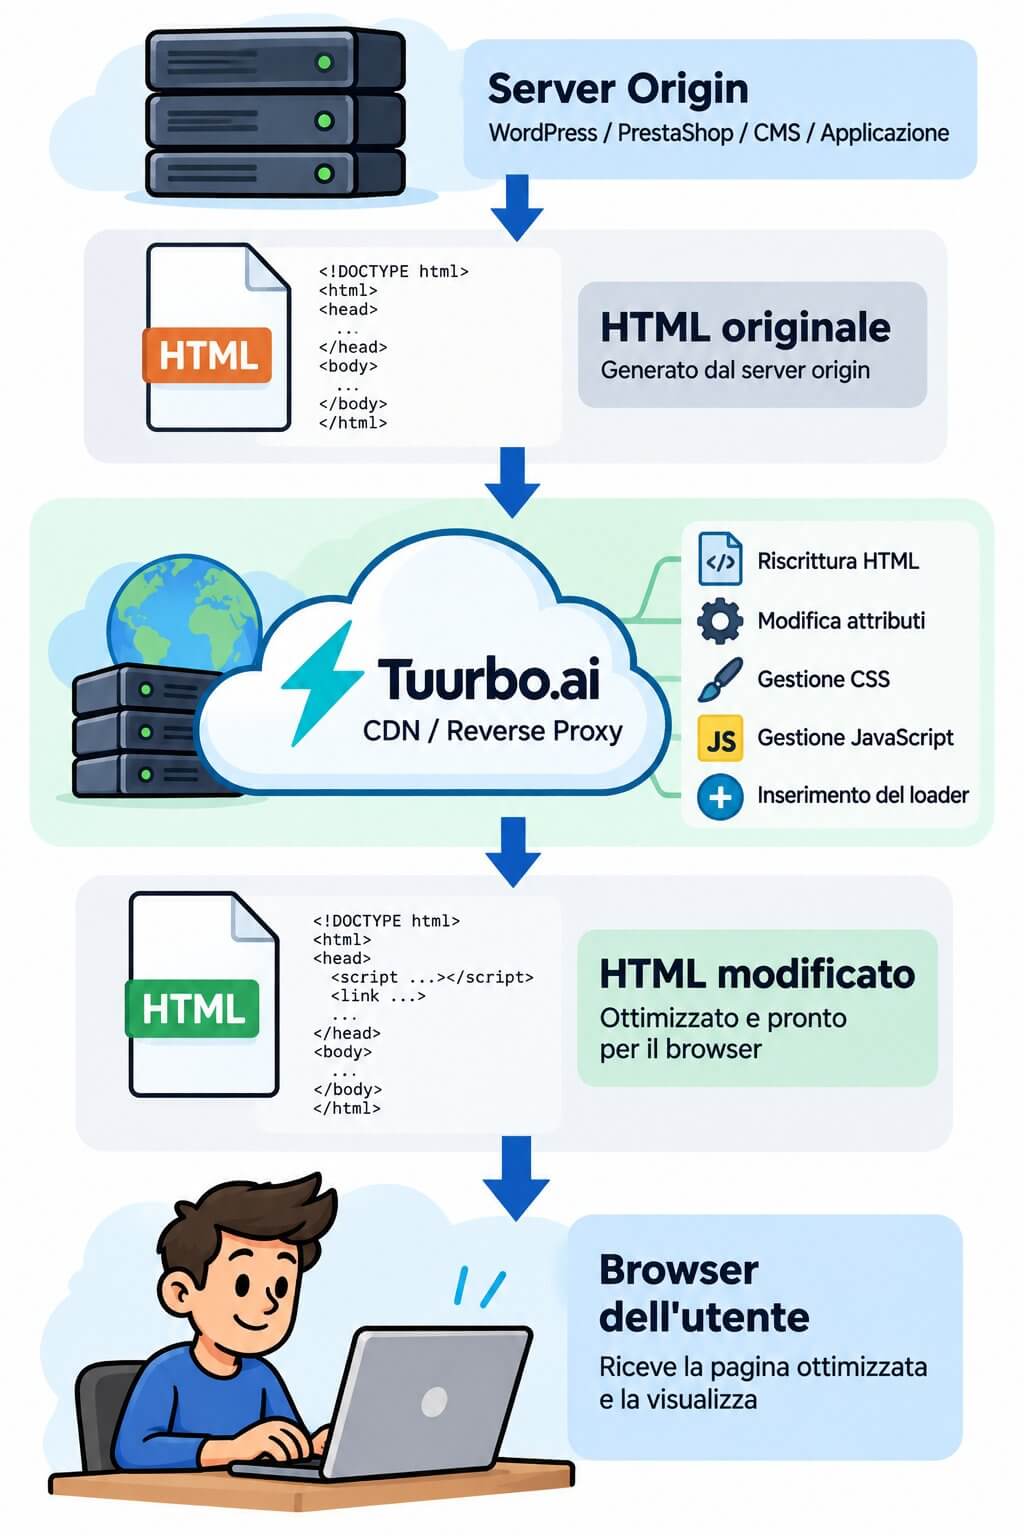
Il server origin genera il proprio HTML, ma quel documento può essere intercettato e trasformato prima di essere consegnato al browser:
Ed è qui che bisogna distinguere questa architettura dalla concezione più semplice di CDN.
Una CDN tradizionale viene normalmente associata alla distribuzione geografica delle risorse: immagini, CSS, JavaScript, font e altri file vengono memorizzati in nodi geograficamente più vicini al visitatore, riducendo latenza e carico sull’origin.
Un reverse proxy può però fare molto di più.
Può modificare direttamente la risposta prodotta dal server prima di consegnarla al client.
Questo significa che il CMS può generare un determinato documento HTML e il browser dell’utente può riceverne una versione differente.
Per esempio, il server potrebbe produrre:
<img src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" data-wp-preserve="%3Cscript%20src%3D%22%2Fjs%2Fapp.js%22%3E%3C%2Fscript%3E" data-mce-resize="false" data-mce-placeholder="1" class="mce-object mce-object-script" width="20" height="20" alt="&lt;script&gt;" />
Durante il passaggio attraverso il layer di ottimizzazione, questo elemento può essere trasformato concettualmente in qualcosa di simile:
<img src="data:image/gif;base64,R0lGODlhAQABAIAAAAAAAP///yH5BAEAAAAALAAAAAABAAEAAAIBRAA7" data-wp-preserve="%3Cscript%20type%3D%22tuurbo%2Fjavascript%22%20data-tbdelay-src%3D%22%2Fjs%2Fapp.js%22%3E%3C%2Fscript%3E" data-mce-resize="false" data-mce-placeholder="1" class="mce-object mce-object-script" width="20" height="20" alt="&lt;script&gt;" />
Lo script continua a essere presente logicamente nella pagina, ma per il browser non è più immediatamente un JavaScript eseguibile.
L’attributo originale viene parcheggiato altrove e sarà successivamente il loader a decidere quando ripristinare ed eseguire quella risorsa.
Lo stesso principio può essere utilizzato con CSS, immagini, iframe e altri elementi.
Rewriting HTML e manipolazione del DOM sono due fasi diverse
È utile fare una distinzione tecnica.
La prima trasformazione avviene prima che la pagina arrivi al browser.
In questa fase sarebbe improprio parlare realmente di manipolazione del DOM, perché il browser non ha ancora costruito alcun Document Object Model. Esiste una risposta HTML che il reverse proxy può analizzare e riscrivere.
È qui che possono essere modificati attributi come src, type e rel, inseriti attributi data-*, modificate risorse e aggiunto il JavaScript necessario al funzionamento del sistema.
Poi la pagina arriva a Chrome, Firefox, Safari o un altro browser.
Il browser effettua il parsing dell’HTML, costruisce il DOM e a quel punto entra in gioco il secondo livello: il JavaScript iniettato può manipolare direttamente il documento e il runtime del browser.
Può creare nodi, cambiare attributi, sostituire elementi, intercettare chiamate, posticipare script e generare artificialmente eventi.
Abbiamo quindi due livelli distinti:
- rewriting dell’HTML lato edge/reverse proxy, prima che il documento venga consegnato al browser;
- manipolazione client-side del DOM e del runtime JavaScript, una volta che il browser ha iniziato a elaborare la pagina.
Questa distinzione è importante perché spiega come sia possibile applicare ottimizzazioni anche senza modificare direttamente tema, plugin o codice sorgente dell’applicazione.
Il sito originale continua a generare una cosa; il layer intermedio può consegnarne un’altra.
L’iniezione JavaScript permette di orchestrare il caricamento
Il reverse proxy può neutralizzare temporaneamente alcune risorse, ma serve poi qualcosa che ne controlli la successiva riattivazione.
È qui che entra in gioco il componente che ci interessa maggiormente: il Tuurbo Loader.
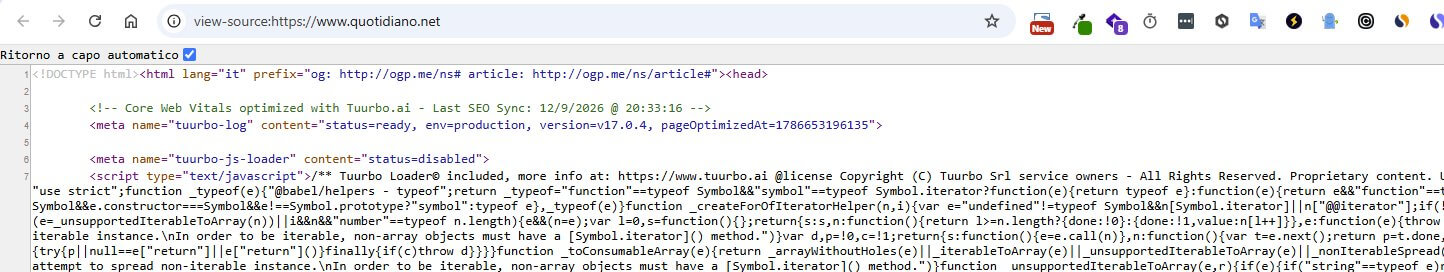
Il loader può leggere gli attributi introdotti durante la trasformazione dell’HTML e decidere quando scaricare, ripristinare o eseguire le varie componenti della pagina.
Da questo punto di vista non siamo di fronte al semplice script di analytics infilato in fondo al documento.
Il loader diventa un vero e proprio orchestratore del caricamento.
Può decidere quando eseguire gli script originariamente presenti, quando riattivare gli stylesheet, quando rendere disponibili alcune immagini e quando simulare determinati eventi del browser.
Ed è proprio qui che comincia la parte interessante della nostra analisi.
Il loader: cosa fa davvero
Il componente centrale si chiama Tuurbo Loader ed è uno script inline, minificato e transpilato con Babel, iniettato nelle pagine interessate.
Il meccanismo principale è quello che normalmente viene chiamato JavaScript delay.
La tecnica, presa da sola, non ha nulla di strano.
Viene utilizzata anche da strumenti molto conosciuti come WP Rocket, FlyngPress con la funzione “Delay JavaScript execution”, Flying Scripts e diversi altri plugin di caching e performance.
Il principio è relativamente semplice.
Lato server o edge, i normali tag <script> vengono modificati in maniera tale che il browser non li esegua immediatamente.
Nel caso analizzato, l’attributo type diventa tuurbo/javascript, mentre gli attributi originali possono essere conservati all’interno di proprietà come data-tbdelay-src e data-tbdelay-type.
Per il browser quello non è più un normale script JavaScript da eseguire durante il parsing.
A quel punto entra in gioco il loader.
Tra le operazioni individuate nel codice ci sono:
- l’attivazione delle immagini LCP marcate con la classe
tb-lazyload-lcp-image; - il preload degli script bloccanti attraverso
<link rel="preload" as="script">; - l’esecuzione sequenziale degli script render-blocking, async e defer;
- la generazione di eventi sintetici come
DOMContentLoaded,readystatechangeeload; - la successiva riattivazione di stylesheet precedentemente neutralizzati.
Fin qui, tecnicamente, niente di particolarmente scandaloso, anzi la dimostrazione che il prodotto sia conforme alle best practices di prodotti e servizi di ottimizzazione PageSpeed.
È un approccio invasivo, certamente complesso e potenzialmente fragile, ma può essere utilizzato per ottenere benefici reali esattamente come fanno decine di prodotti analoghi e sviluppatori Web da ormai oltre un decennio.
Il problema non è quindi il JavaScript delay in sé.
Il punto davvero interessante è capire quando il loader decida di far partire gli script.
Le tre righe che cambiano tutto
Nel loader che abbiamo analizzato compare una costante particolarmente significativa:
DELAY_TIMING = {
DESKTOP: 1,
MOBILE: 1,
LIGHTHOUSE: 5e4
}
I valori sono espressi in millisecondi.
Per un visitatore desktop il JavaScript viene riattivato con un delay pari a 1 millisecondo.
Per un visitatore mobile il comportamento è sostanzialmente lo stesso.
Per Lighthouse, invece, il valore è 5e4.
Ovvero: 50.000 millisecondi.
Cinquanta secondi.
Il punto non è semplicemente che Lighthouse riceva un delay maggiore.
È l’ordine di grandezza a essere interessante.
Un ritardo di cinquanta secondi porta l’esecuzione degli script ben oltre la normale finestra nella quale un audit Lighthouse completa la propria analisi della pagina.
Di conseguenza, durante buona parte del test, il JavaScript originale del sito non viene eseguito.
E se il JavaScript non viene eseguito, una quantità enorme di lavoro sparisce dal main thread durante l’audit.
Niente long task generati da quei bundle.
Niente inizializzazione di molti widget.
Niente carousel.
Niente popup.
Niente codice di terze parti eseguito nel normale intervallo di misurazione.
Il test si trova quindi a misurare una pagina molto più leggera rispetto a quella che un visitatore reale utilizza nella pratica.
Come viene riconosciuto Lighthouse
Il loader contiene una funzione denominata _isAgentLighthouse() che utilizza diversi segnali per provare a capire se il browser che sta caricando la pagina sia riconducibile a un ambiente Lighthouse o comunque automatizzato.
Tra i controlli presenti nel codice analizzato abbiamo individuato elementi come:
/HeadlessChrome/.test(navigator.userAgent);navigator.webdriver;- controlli basati su
eval.toString(); - la presenza della stringa
headlessall’interno dinavigator.appVersion; - la ricerca di riferimenti a
lighthouse,Chrome-Lighthouseemoto g powernello user agent.
Quest’ultimo elemento è particolarmente interessante perché il Moto G Power è stato utilizzato negli ambienti di emulazione mobile collegati agli audit Lighthouse.
Preso singolarmente, naturalmente, il rilevamento di un browser headless non dimostra nulla.
Esistono moltissime ragioni legittime per voler distinguere un browser automatizzato da un visitatore reale: anti-scraping, gestione dei crawler, prevenzione di abusi, compatibility workaround.
La questione cambia quando quel rilevamento viene collegato direttamente a un delay di 50 secondi applicato specificamente al ramo identificato come Lighthouse.
Il dettaglio che rende il comportamento ancora più interessante
Nel codice analizzato compare inoltre un’esclusione esplicita prima di alcuni controlli sullo user agent:
if (
ua.indexOf("instagram") >= 0 ||
ua.indexOf("samsung") >= 0
) return false;
In pratica, se lo user agent contiene riferimenti a Instagram o Samsung, quel browser non viene trattato come Lighthouse attraverso quel ramo di detection.
Una possibile interpretazione tecnica è che siano stati gestiti alcuni falsi positivi.
Browser embedded, Samsung Internet e combinazioni particolari di user agent possono infatti condividere caratteristiche che rischiano di interferire con sistemi di fingerprinting troppo aggressivi.
Ed è proprio questo che rende il comportamento degno di attenzione.
Il rilevamento appare sufficientemente raffinato da cercare di distinguere un ambiente di misurazione da alcuni browser utilizzati da persone reali.
Nel gestore di DOMContentLoaded abbiamo inoltre rilevato che alcune operazioni, comprese quelle collegate all’attivazione delle immagini LCP e al preload, sono subordinate a un controllo del tipo:
if (!this._isAgentLighthouse()) {
// attivazione e preload
}
Durante l’audit, quindi, il comportamento della pagina può risultare significativamente diverso rispetto a quello riservato all’utente ordinario.
Gli effetti collaterali sul DOM e sul runtime JavaScript
Quando si prende il controllo del normale ciclo di caricamento di una pagina bisogna inevitabilmente ricostruire una parte dei comportamenti che il browser e le librerie si aspettano.
Ed è qui che il loader diventa particolarmente invasivo.
Tra le modifiche osservate nel codice troviamo interventi su componenti molto profondi del runtime.
document.readyState viene ridefinito attraverso Object.defineProperty.
Questo significa che una libreria che interroga lo stato del documento potrebbe non ricevere necessariamente il valore nativo così come sarebbe stato prodotto dal normale lifecycle del browser.
Vengono inoltre applicati wrapper o Proxy a metodi del DOM.
Per esempio, Node.prototype.insertBefore viene intercettato in modo da controllare l’inserimento di determinati script.
Nel codice analizzato compare anche un’eccezione specifica per un elemento identificato come audiweb-action.
Anche Node.prototype.removeChild viene intercettato per gestire la rimozione di alcuni elementi.
Altri interventi riguardano:
- la riscrittura di
document.writeedocument.writeln; - l’utilizzo di
jQuery.holdReady(true)per sospendere temporaneamente i normali handlerready; - la gestione artificiale degli eventi
DOMContentLoadedeload; - la riattivazione successiva di script e stylesheet.
Il motivo è comprensibile.
Se un plugin WordPress o uno script PrestaShop si aspetta di essere eseguito al DOMContentLoaded, ma il loader ha intenzionalmente impedito che quello script partisse in quel momento, bisogna successivamente ricreare artificialmente le condizioni che quel software si aspettava.
Ed è qui che iniziano spesso i problemi di compatibilità.
Le patch specifiche per i singoli siti
All’interno del loader abbiamo trovato anche una serie di correzioni specifiche rivolte a singoli domini o a determinate applicazioni.
Il codice contiene workaround relativi, tra le altre cose, a:
- carousel di prodotti;
- banner cookie duplicati;
- popup di autenticazione;
- gallerie Avada;
- slider Slick;
- carrelli PrestaShop;
- dimensioni e posizionamento di elementi della pagina.
In alcuni casi vengono attivati manualmente eventi dell’applicazione come:
prestashop.emit("updateCart")
Dal punto di vista sistemistico questo è perfettamente comprensibile.
Quando si modifica profondamente l’ordine con cui JavaScript, CSS ed eventi vengono eseguiti, alcune applicazioni inevitabilmente smettono di funzionare come previsto.
A quel punto diventano necessari workaround specifici.
È il classico costo della complessità.
Più ci si allontana dal normale lifecycle del browser, più bisogna compensare manualmente le incompatibilità introdotte.
Perché PageSpeed sale ma i dati CrUX possono restare negativi
Arriviamo ora al punto che interessa realmente chi paga un servizio di ottimizzazione.
PageSpeed Insights mette nella stessa schermata due famiglie di dati completamente diverse.
Da una parte abbiamo i dati di campo, provenienti dal Chrome User Experience Report, normalmente indicato come CrUX.
Sono dati raccolti dall’esperienza di navigazione di utenti Chrome reali e aggregati su un intervallo temporale.
Dall’altra abbiamo il test di laboratorio, prodotto attraverso Lighthouse.
Il famoso punteggio da 0 a 100 con il cerchio rosso, arancione o verde nasce dal test di laboratorio.
Ed è fondamentale comprendere che le due cose non sono equivalenti.
Lighthouse esegue una simulazione.
CrUX osserva ciò che accade realmente ai visitatori.
Se il software riconosce Lighthouse e gli presenta un comportamento differente, è perfettamente possibile ottenere contemporaneamente:
98 o 100 nel test sintetico e Core Web Vitals non superati nei dati reali.
Non c’è alcuna contraddizione.
Cosa vede Lighthouse
Se durante l’audit il JavaScript applicativo viene ritardato di cinquanta secondi, Lighthouse può misurare una pagina sulla quale gran parte del lavoro non è ancora avvenuta.
Il Total Blocking Time può diminuire drasticamente perché molti long task semplicemente non vengono eseguiti.
Il layout può risultare più stabile perché alcuni widget non sono ancora stati inizializzati.
Il main thread rimane più libero.
Popup, advertising, slider, componenti interattivi e script di terze parti possono non essere ancora entrati realmente in gioco.
Il risultato è matematicamente corretto.
Il problema è un altro:
quella potrebbe non essere la stessa esperienza servita all’utente reale.
Cosa vede invece l’utente
Per un browser normale il delay individuato nel codice è pari a un millisecondo.
Questo significa che il lavoro JavaScript non viene eliminato.
Viene rimandato.
E spostare il lavoro non significa necessariamente ridurlo.
Anzi, in alcuni casi ritardare artificialmente numerosi script può concentrare una grande quantità di lavoro in una fase successiva del caricamento.
Da qui possono nascere problemi sulle metriche reali.
INP, Interaction to Next Paint, è particolarmente importante perché misura la capacità della pagina di rispondere alle interazioni dell’utente.
Se l’utente clicca o tocca qualcosa mentre il main thread sta eseguendo una grossa quantità di JavaScript posticipato, il ritardo diventa esperienza reale.
Anche il CLS può risentirne.
Uno script ritardato può inserire un banner, inizializzare uno slider, modificare l’altezza di un contenitore o aggiungere dinamicamente un widget dopo che la pagina è già stata renderizzata.
Il browser reale registra lo spostamento.
Un test terminato prima dell’esecuzione di quello script potrebbe invece non vederlo.
Il LCP può al contrario migliorare realmente grazie a tecniche corrette come prioritizzazione e preload dell’immagine principale.
Ed è importante sottolinearlo: non significa che ogni ottimizzazione effettuata dal sistema sia necessariamente falsa o inefficace.
Il problema nasce quando la configurazione osservata dal sistema di benchmark differisce significativamente da quella osservata dagli utenti reali.
Il punteggio PageSpeed non è il sito
Questa vicenda evidenzia ancora una volta un equivoco che incontriamo continuamente nei progetti di performance.
PageSpeed Insights non misura “quanto è veloce un sito” con un singolo numero assoluto.
Il punteggio Lighthouse è un indice diagnostico ottenuto attraverso una determinata metodologia di test.
È utilissimo.
Lo utilizziamo anche noi.
Ma va interpretato.
Un 100 ottenuto rendendo la pagina meno rappresentativa dell’esperienza reale vale molto meno di un 80 ottenuto da una pagina che esegue realmente tutto ciò che l’utente deve utilizzare.
È come misurare il consumo di un server disattivando temporaneamente tutti i processi pesanti durante il benchmark.
Il numero migliora.
Il workload reale no.
Non è la prima volta che osserviamo questo modello
Abbiamo già discusso un comportamento concettualmente simile nella nostra analisi su Kleecks, iSmartframe e le CDN che ottimizzano i Core Web Vitals.
Il pattern generale è noto:
- un layer viene posizionato tra il sito e il visitatore;
- quel layer può modificare la risposta;
- il sistema cerca di identificare il software di benchmark;
- al benchmark può essere consegnato un comportamento diverso da quello del visitatore reale;
- il cliente vede quindi un punteggio sintetico enormemente migliore.
Dal punto di vista commerciale il vantaggio è evidente, un punteggio in cui è tutto verde si vende molto più facile rispetto ad un punteggio di 70 arancio.
Ottimizzare davvero un sito richiede spesso settimane di lavoro.
Bisogna intervenire sulle query SQL, eliminare plugin, sistemare temi WordPress, ridurre JavaScript, modificare template, analizzare cache object e page cache, ottimizzare immagini, correggere integrazioni esterne, fare subsetting dei font, verificare API lente e intervenire sul database e molto molto molto molto altro.
È lavoro sistemistico e applicativo, artigianale e mai automatizzato.
Richiede competenze, accesso al codice e spesso collaborazione con gli sviluppatori.
Aumentare un punteggio sintetico attraverso un layer esterno è invece molto più semplice da vendere e molto più facile da mostrare in uno screenshot.
Cosa dicono le AI di quel codice Javascript Tuurbo Loader ?
Abbiamo voluto chiedere alle principali e più famose AI (Large Language Model) qualche parere su questo loader, perchè ci rendiamo conto che alcune considerazioni che possono emergere dalla nostra analisi sopra lasciano ipotizzare condotte quanto meno discutibili sulla trasparenza dei test eseguiti e pertanto ci sembrava doveroso chiedere un parere superpartes, non per forza una recensione Tuurbo.ai ai principali LLM sulla base esclusiva del codice del loader incollato.
Abbiamo coinvolto in ordine le principali 3, con ChatGPT di OpenAI con il modello 5.6-Sol, Gemini nella versione Pro e infine Claude con modello Fable 5.1 di Anthropic, i risultati sono stati tutti piuttosto chiari precisi e concordanti.
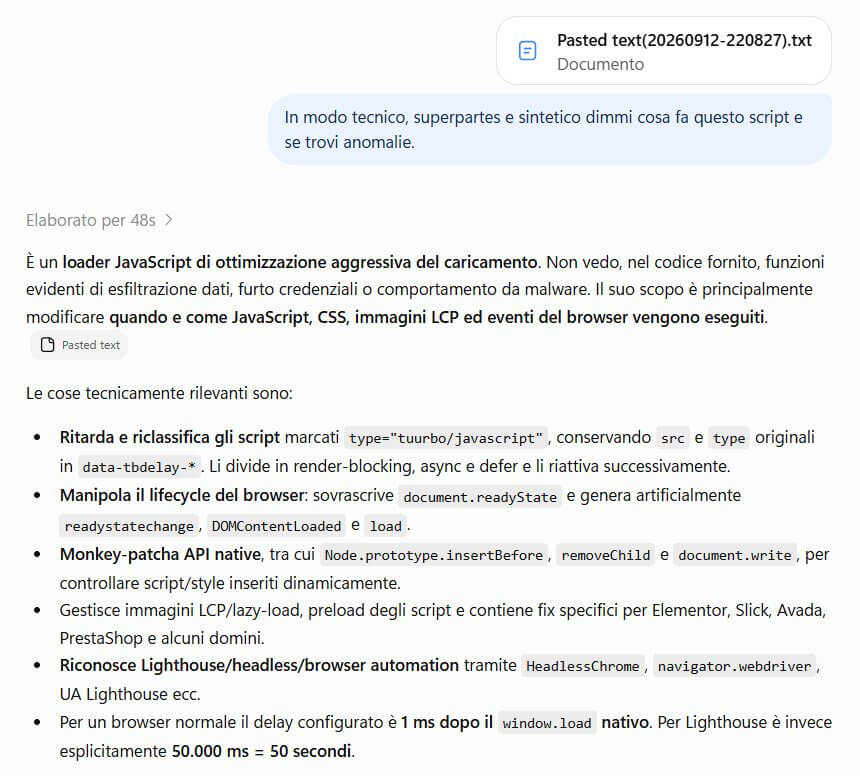
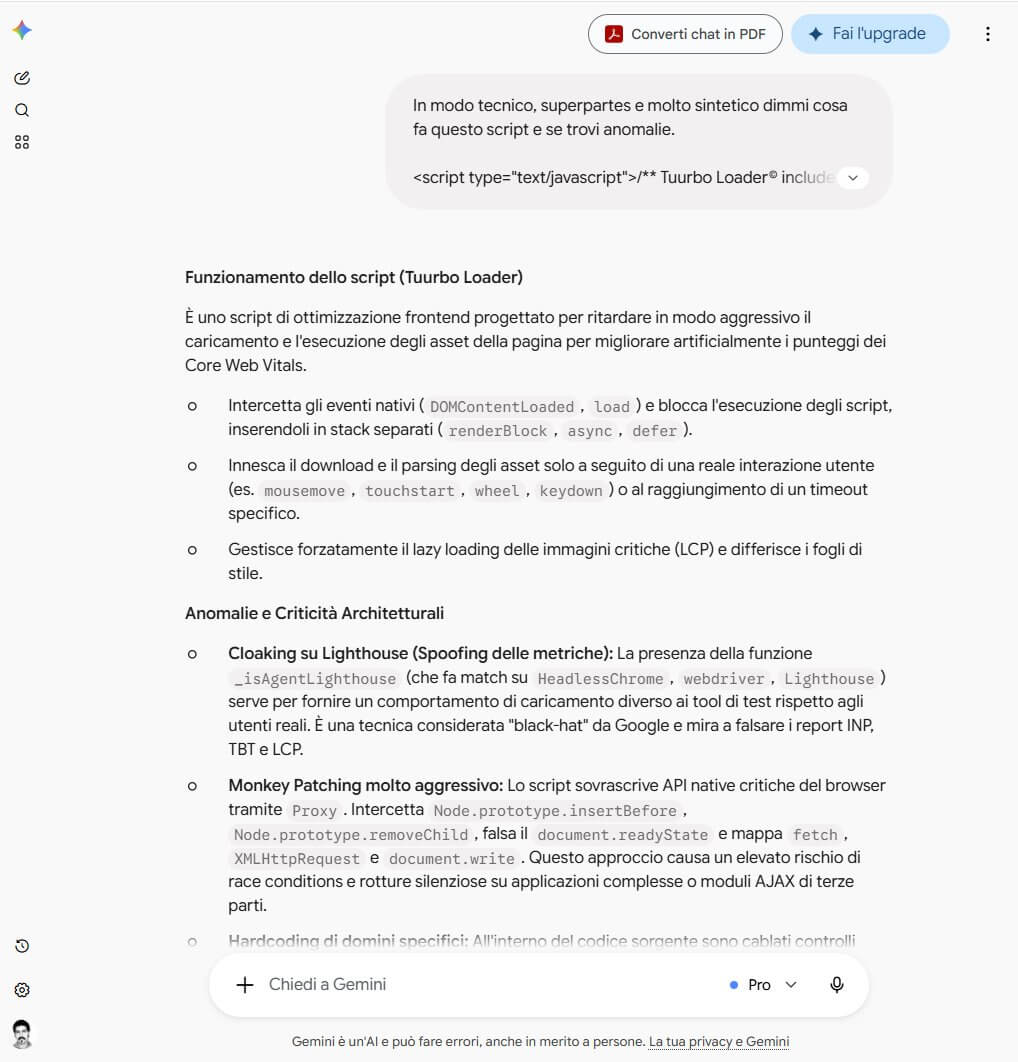
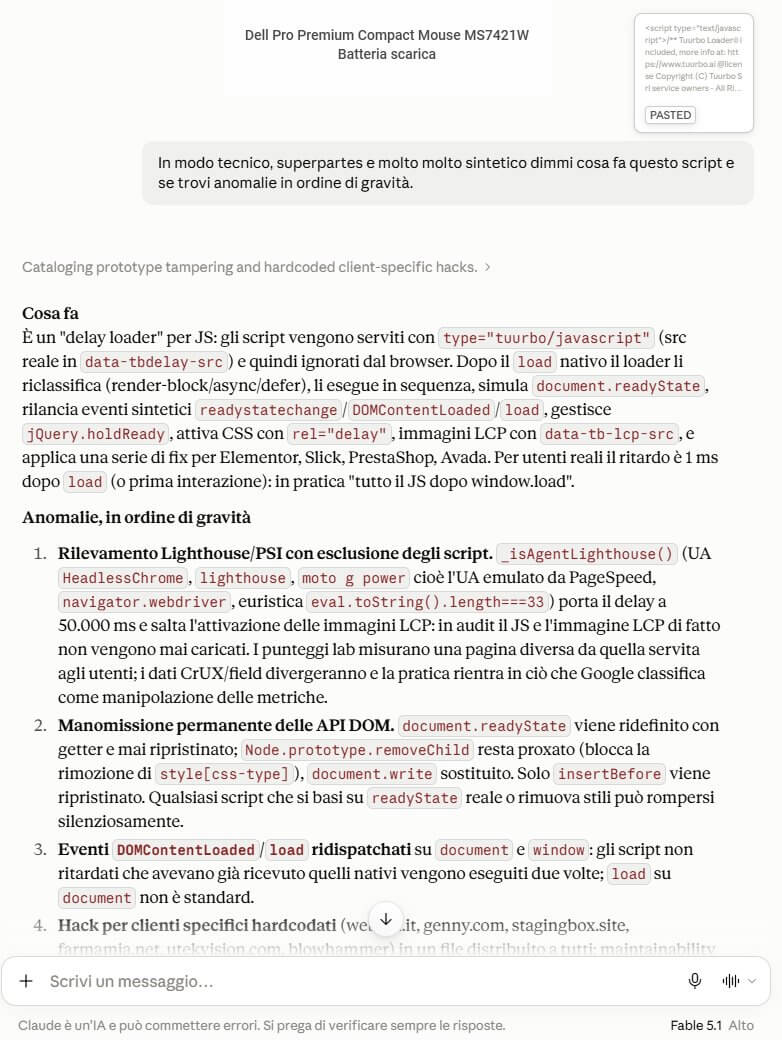
Nonostante la richiesta esplicita nel promptdi essere superpartes e molto sintetico, Gemini da un verdetto tanto grave quanto impietoso arrivando a dire senza mezzi termini :
È una tecnica considerata “black-hat” da Google e mira a falsare i report INP, TBT e LCP.
Quello che però va detto a difesa di Tuurbo.ai
Sarebbe scorretto trasformare questa analisi in un “non funziona niente”.
Non è quello che stiamo sostenendo.
Diverse tecniche utilizzate dal prodotto sono tecnicamente valide.
Il JavaScript delay è una tecnica reale.
Il preload delle immagini LCP è una tecnica reale.
Una CDN può produrre benefici reali.
La cache può produrre benefici reali.
La trasformazione delle immagini può produrre benefici reali.
L’eliminazione o il rinvio di risorse non critiche può rendere realmente una pagina più veloce.
Un sito WordPress molto pesante potrebbe quindi risultare concretamente migliore per un utente dopo l’installazione di un layer di questo tipo.
È inoltre vero che il rilevamento di browser headless ha utilizzi assolutamente legittimi.
Il punto della nostra analisi non è contestare queste tecniche.
Il punto è la combinazione tra detection specifica dell’ambiente Lighthouse e un delay pari a 50.000 millisecondi.
LIGHTHOUSE: 5e4
È difficile considerare quel valore alla stregua di una normale ottimizzazione applicata uniformemente ai visitatori.
Il codice che abbiamo analizzato distingue chiaramente il comportamento.
E proprio questa distinzione deve far riflettere chi utilizza PageSpeed Insights come principale dimostrazione del miglioramento ottenuto.
Il paragone con un “defeat device”
Il parallelismo che viene spontaneo è quello con i cosiddetti defeat device diventati famosi con il caso Volkswagen.
Nel 2015 emerse che alcuni veicoli erano in grado di riconoscere determinate condizioni associate ai test di omologazione e modificare di conseguenza il comportamento del motore.
Il punto concettuale non era soltanto il fatto che esistesse una modalità differente.
Era che il sistema di misurazione osservava un comportamento che non rappresentava quello normalmente presente nelle condizioni d’uso reali.
Naturalmente stiamo parlando di ambiti completamente differenti e il paragone va inteso esclusivamente sul piano del meccanismo logico.
Nel caso analizzato qui abbiamo un software che cerca di riconoscere un ambiente di benchmark e associa a quel ramo una configurazione differente:
DESKTOP: 1
MOBILE: 1
LIGHTHOUSE: 50000
Utente normale: un millisecondo.
Lighthouse: cinquanta secondi.
È difficile trovare una rappresentazione più sintetica del problema.
Il vero banco di prova sono gli utenti reali
Alla fine, però, il problema si risolve da solo guardando il dato corretto.
Se una pagina ottiene 100 in Lighthouse ma continua ad avere LCP, CLS o INP insufficienti nei dati reali, il sito non ha risolto il problema dei Core Web Vitals.
Ha migliorato un benchmark.
Ed è esattamente per questo che chi si occupa seriamente di performance non può fermarsi allo screenshot di PageSpeed.
Bisogna guardare Search Console.
Bisogna guardare CrUX.
Bisogna usare Real User Monitoring quando possibile.
Bisogna osservare il comportamento del sito con utenti autentici, dispositivi autentici e connessioni autentiche.
E, soprattutto, bisogna aprire Chrome DevTools e leggere il codice.
Conclusioni
Tuurbo.ai utilizza un’architettura tecnicamente interessante.
Una CDN e un reverse proxy permettono di intercettare la risposta dell’origin, riscrivere l’HTML e iniettare un loader JavaScript.
Il loader prende poi il controllo di una parte importante del lifecycle della pagina: ritarda script, gestisce risorse, manipola il DOM, intercetta metodi nativi, produce eventi sintetici e applica workaround specifici.
Molte di queste tecniche possono essere utilizzate legittimamente per migliorare le prestazioni.
Il punto che riteniamo problematico è un altro.
Nel loader che abbiamo analizzato esiste un comportamento specifico per Lighthouse, con un delay di 50 secondi contro il millisecondo riservato agli utenti normali.
Questo significa che un audit sintetico può osservare una pagina sostanzialmente differente rispetto a quella che viene realmente utilizzata da una persona.
Ed è una spiegazione molto plausibile per il fenomeno da cui siamo partiti:
PageSpeed Insights quasi perfetto e Core Web Vitals reali ancora insufficienti.
Per chi gestisce un sito web, la lezione più importante non riguarda nemmeno Tuurbo.
Riguarda il modo in cui si valutano le performance.
Un cerchio verde con scritto 100 non è una certificazione.
Non è un ranking factor isolato.
Non dimostra che gli utenti stiano ricevendo una buona esperienza.
È un test sintetico, eseguito in condizioni precise.
Se volete sapere davvero quanto è veloce un sito, guardate ciò che succede fuori dal laboratorio.
Guardate il browser di un utente reale.
Guardate il main thread.
Guardate l’INP.
Guardate il CLS.
Guardate il CrUX.
E quando i numeri sembrano troppo belli per essere compatibili con quello che state osservando sul campo, fate la cosa più semplice di tutte:
aprite il sorgente e leggete il codice.
Questa analisi è basata sulla lettura del loader JavaScript versione 19.0.1 rilevato in produzione su siti terzi nel 2026. Le descrizioni tecniche fanno riferimento al comportamento osservato nel codice analizzato anche da AI (Claude e ChatGPT). Le valutazioni sulle finalità e sulle conseguenze di tale comportamento rappresentano la nostra personale interpretazione tecnica. Il software può evolvere e versioni successive potrebbero presentare implementazioni differenti.

